23 oktober 2026
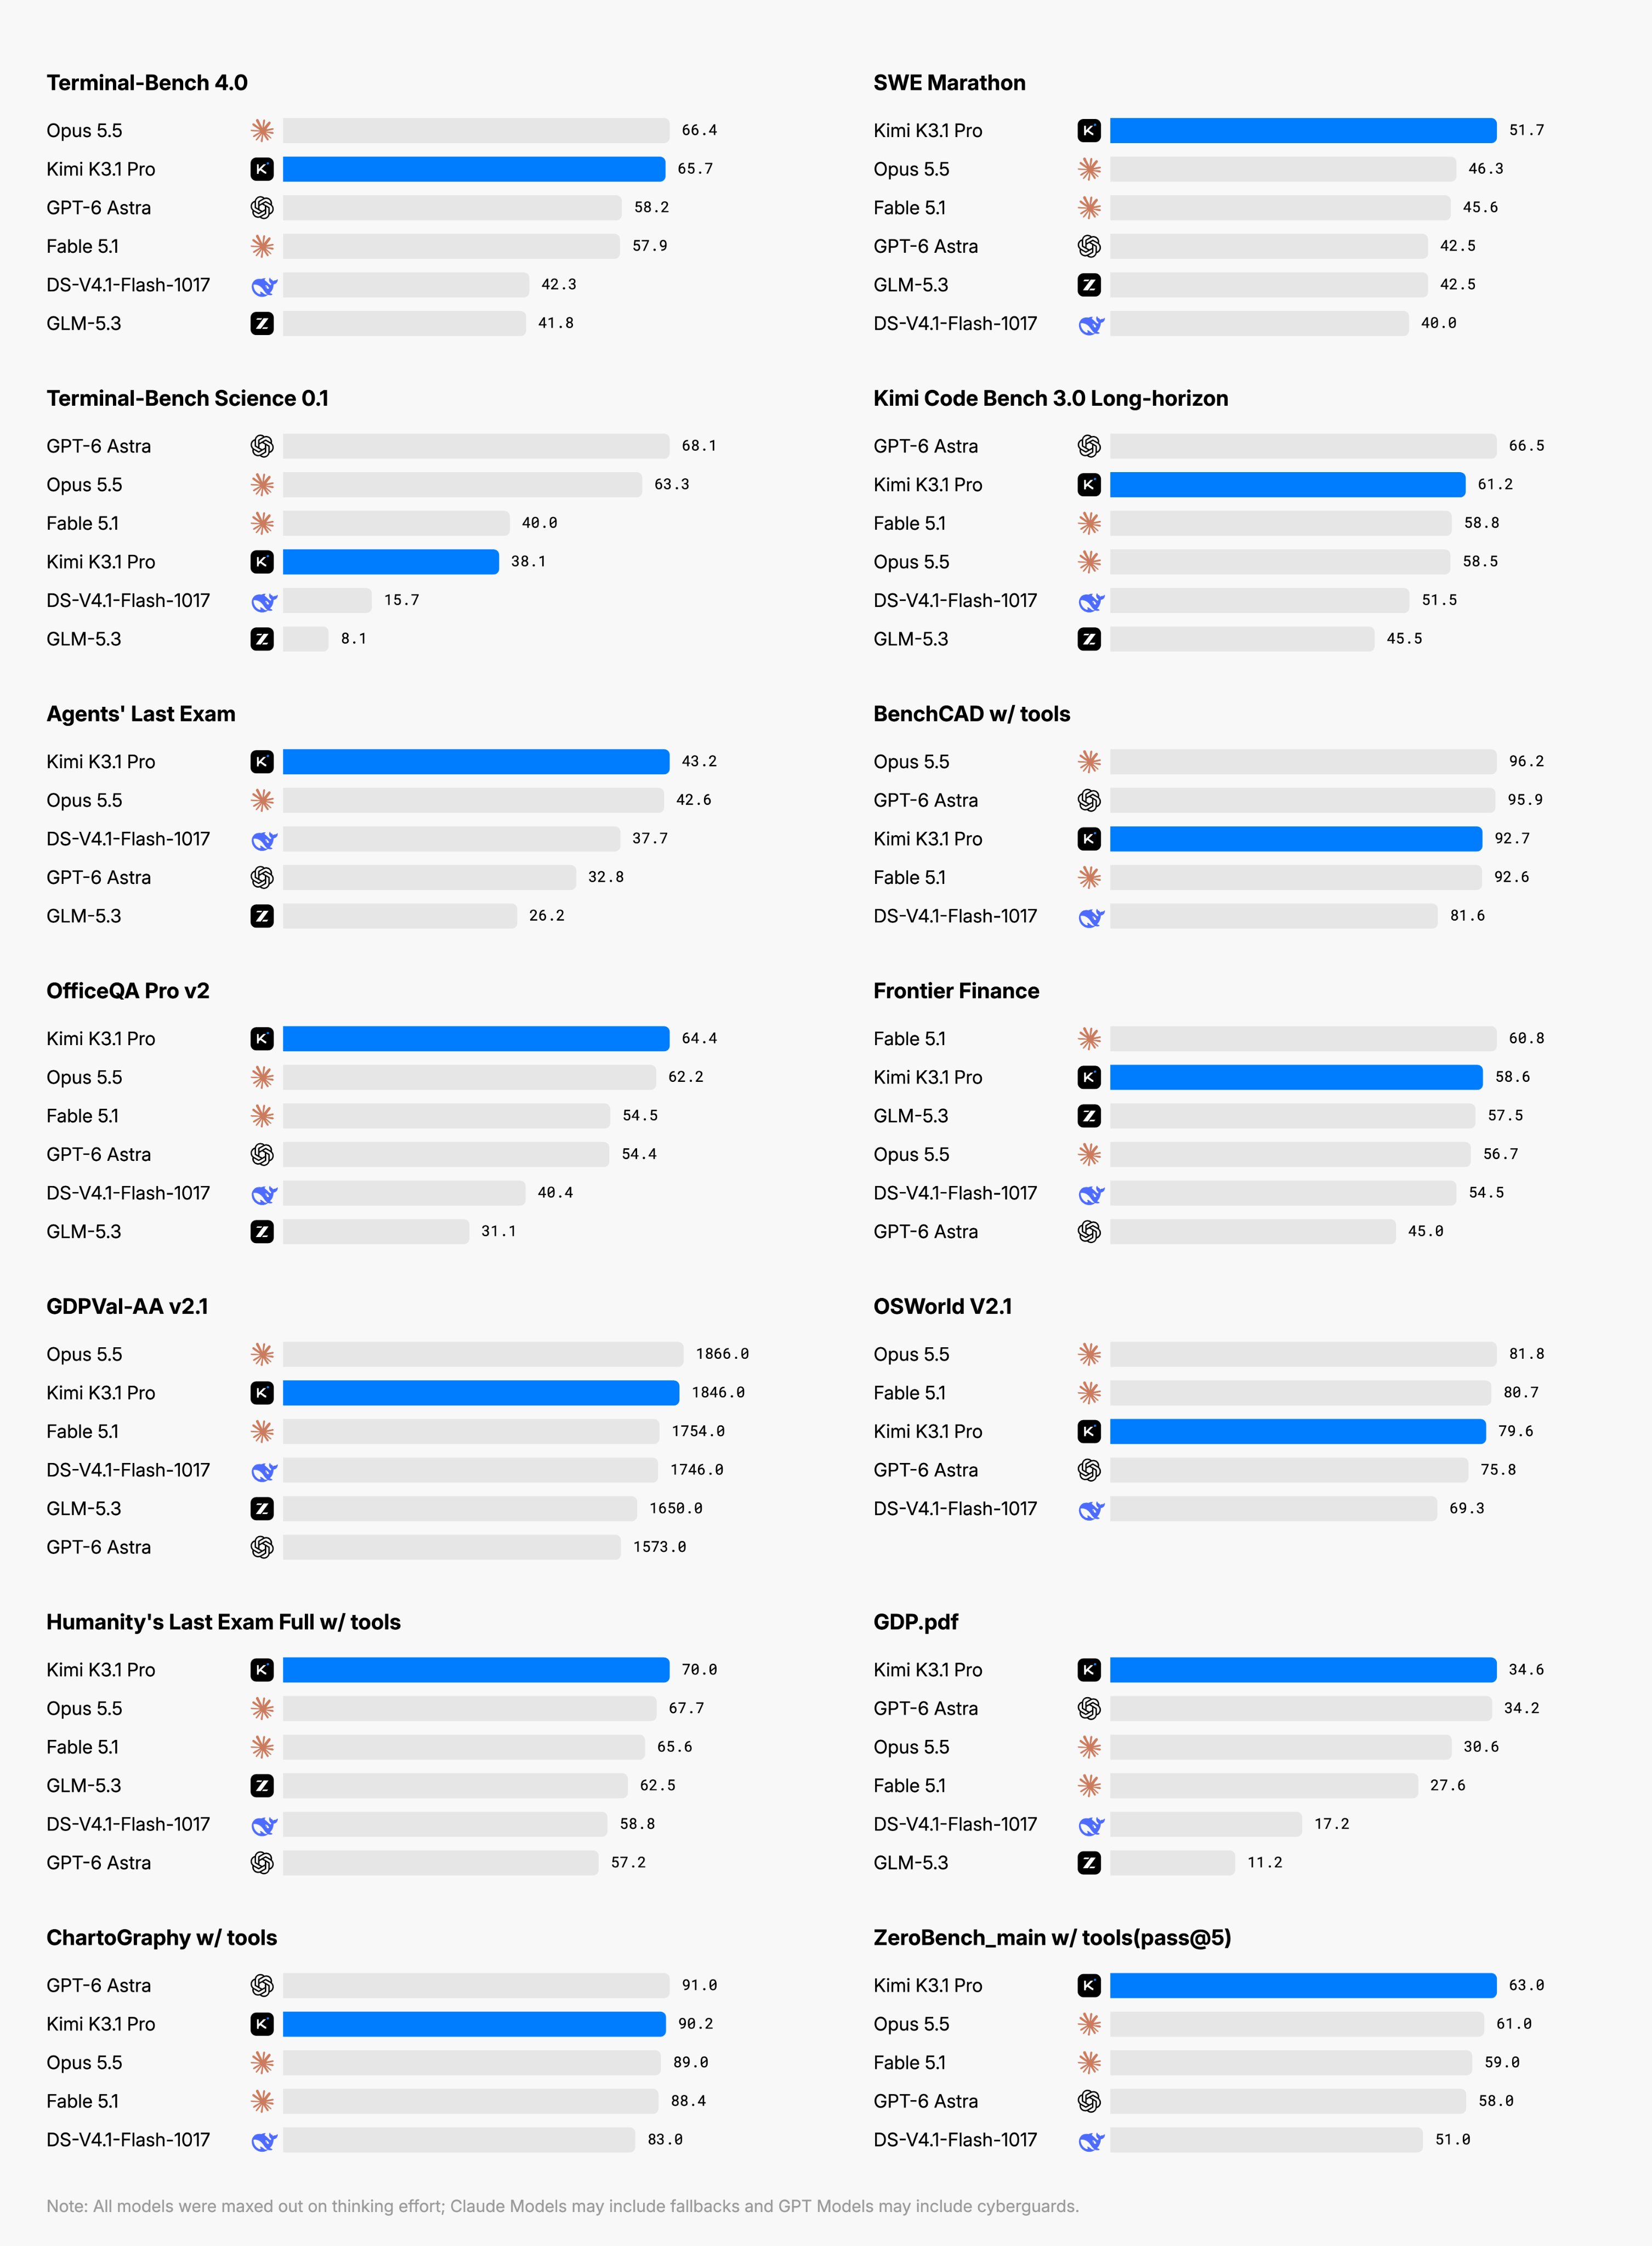
Kimi AI K3.1 Pro pakt zes eerste plaatsen in de veertien grafieken die Moonshot zelf publiceert. Toch ligt het model bij de ene terminaltest vlak achter Opus en bij de andere 30 procentpunt achter Astra.
Dat verschil raakt je keuze: een model dat goed code repareert, hoeft niet de beste keuze te zijn voor een wetenschappelijke opdracht. We hebben alle veertien vergelijkingen nageteld. Geen eigen modeltest: de resultaten komen van Moonshot, de telling en uitsplitsing hieronder zijn van WatisAI.
6 van 14
Eerste plaatsen voor Kimi binnen de getoonde selectie. Opus staat viermaal bovenaan, Astra driemaal en Fable eenmaal.
Zes zeges maken Kimi geen winnaar voor elke taak
Wij vinden Kimi K3.1 Pro een serieuze kandidaat voor een vergelijking op je eigen werk. De algemene claim dat het model de concurrentie verslaat, gaat verder dan deze grafieken laten zien.
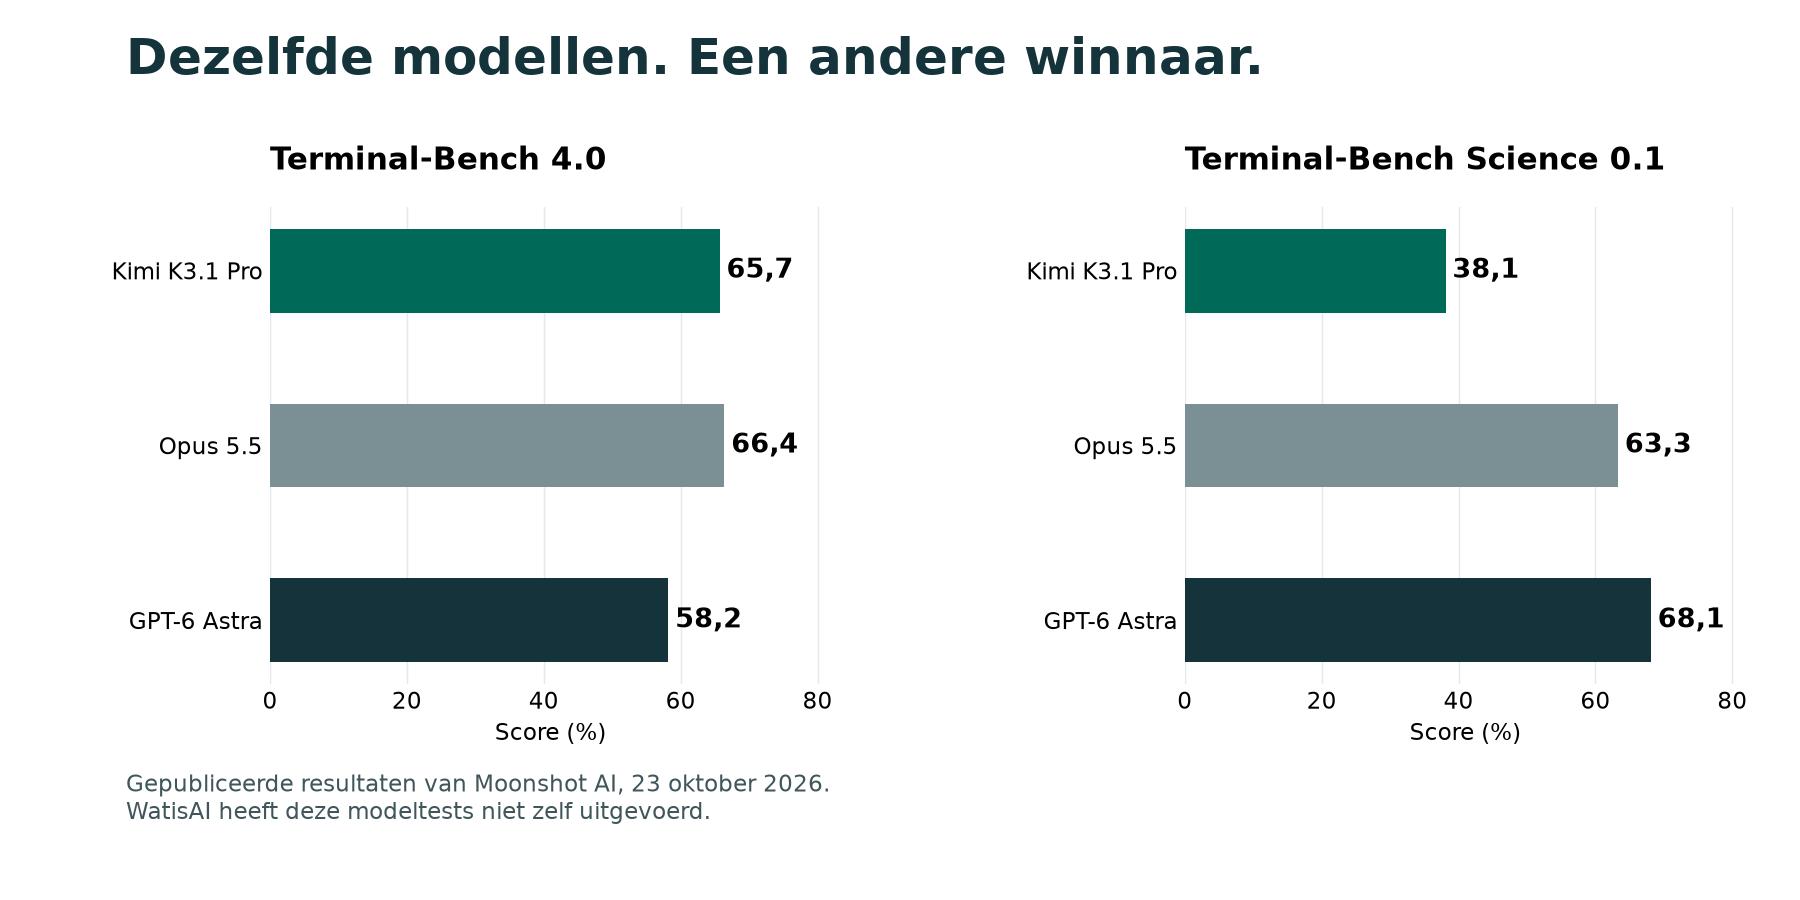
Neem Terminal-Bench 4.0: Kimi haalt 65,7, Opus 66,4 en Astra 58,2. Bij Terminal-Bench Science 0.1 haalt Kimi 38,1 en Astra 68,1. Dat is 30 procentpunt verschil, ondanks de verwante testnamen.
Waar staat Kimi AI K3.1 Pro bovenaan?
De tabel neemt alle veertien grafieken uit de aankondigingsafbeelding mee. We tellen per grafiek de hoogste getoonde waarde. Ontbrekende modellen tellen niet mee. De scores hebben verschillende schalen; daarom berekenen we geen totaalgemiddelde.
| Benchmark | Kimi | Hoogste score |
|---|---|---|
| Terminal-Bench 4.0 | 65,7 | Opus 5.5 (66,4) |
| SWE Marathon | 51,7 | Kimi (51,7) |
| Terminal-Bench Science 0.1 | 38,1 | Astra (68,1) |
| Kimi Code Bench 3.0 Long-horizon | 61,2 | Astra (66,5) |
| Agents' Last Exam | 43,2 | Kimi (43,2) |
| BenchCAD with tools | 92,7 | Opus 5.5 (96,2) |
| OfficeQA Pro v2 | 64,4 | Kimi (64,4) |
| Frontier Finance | 58,6 | Fable 5.1 (60,8) |
| GDPval-AA v2.1 | 1846,0 | Opus 5.5 (1866,0) |
| OSWorld V2.1 | 79,6 | Opus 5.5 (81,8) |
| Humanity's Last Exam Full with tools | 70,0 | Kimi (70,0) |
| GDP.pdf | 34,6 | Kimi (34,6) |
| ChartoGraphy with tools | 90,2 | Astra (91,0) |
| ZeroBench_main with tools pass@5 | 63,0 | Kimi (63,0) |
De kolom Kimi betreft steeds K3.1 Pro. Opus en Fable zijn versie 5.5 en 5.1; Astra is GPT-6 Astra. Aantal zeges weegt een kleine test even zwaar als een grote. Het is een telling van deze afbeelding, geen ranglijst voor alle AI-taken.
De agentsoftware telt mee in de score
Moonshot vermeldt dat Kimi verschillende codebenchmarks doorliep met de Claude Code-harness. Dat is de software die opdrachten, bestanden en gereedschappen aan het model aanbiedt. Andere tests gebruiken andere omgevingen.
Bij AI-agents beoordeel je dus het samenspel van model en gereedschap. Een andere agentomgeving kan een andere uitkomst geven. Onze uitleg over de agent loop laat zien waarom de stap van antwoord naar actie extra foutmomenten introduceert.
Bekijk de volledige benchmarkafbeelding van Moonshot
23,4 → 8,3%
Aandeel foutieve claims in Kimi Hallu Bench Hard, volgens Moonshot. Een interne stresstest.
65% minder hallucinaties is geen foutloos financieel advies
De daling van 23,4% naar 8,3% is relatief ongeveer 64,5%, afgerond 65%. Absoluut is het verschil 15,1 procentpunt. Het gaat om foutieve claims op een opzettelijk moeilijke interne test.
Moonshot schrijft zelf dat deze percentages geen algemene foutkans in dagelijks gebruik voorstellen. Je kunt hier dus niet uit afleiden dat 91,7% van elk financieel antwoord klopt. Controle van cijfers en bronnen blijft nodig; meer over die foutsoorten staat bij AI-hallucinaties.
De zes overwinningen zomaar wegzetten is óók te makkelijk
Onze telling bewijst geen superioriteit, maar ze geeft evenmin een reden om de resultaten te negeren. Kimi staat in deze selectie bovenaan bij onder meer SWE Marathon, OfficeQA Pro v2 en Humanity’s Last Exam met tools. Dat zijn verschillende soorten opdrachten.
Dat de maker de cijfers publiceert, maakt ze niet automatisch onjuist. Het ontbrekende stuk is een herhaalde vergelijking op jouw taak, met dezelfde invoer en duidelijke succescriteria. Ook één mooie 3D-demo levert dat bewijs niet.
Nu te gebruiken, modelgewichten uiterlijk 4 november
Volgens de aankondiging komt K3.1 Pro beschikbaar in Kimi, Kimi Work, Kimi Code en de API. Highspeed zou twee tot drie keer sneller zijn. Die snelheidsclaim hebben we niet zelf gemeten.
De downloadbare modelgewichten volgen volgens Moonshot uiterlijk 4 november 2026. Dat is een toezegging. De basis bouwt voort op Kimi K3; één miljoen tokens context is op zichzelf dus geen bewijs van een doorbraak in deze update.
Vergelijk één echte opdracht vóór je overstapt
- Neem één afgeronde, niet-vertrouwelijke opdracht waarvan je het juiste resultaat kent.
- Geef beide modellen dezelfde bestanden, instructies en toegestane gereedschappen.
- Controleer de uitkomst op vooraf vastgelegde fouten en noteer tijd, herstelwerk en kosten.
Kies pas daarna welk model je op méér van dat werk inzet. Voor de basis achter taalmodellen kun je terug naar wat is AI.
Veertien providervergelijkingen, nul nieuwe modelruns
WatisAI heeft op 23 oktober 2026 de veertien grafieken uit de aankondigingsafbeelding overgenomen, de hoogste getoonde waarde per grafiek bepaald en de twee terminaltests naast elkaar gezet. De modeluitvoeringen zijn niet herhaald. We combineren verschillende meeteenheden niet tot één score.
Bronnen: Moonshot AI, Introducing Kimi K3.1 Pro en de bijbehorende benchmarkvoetnoten, 23 oktober 2026; officiële X-aankondiging van Kimi, dezelfde datum; Kimi API-documentatie voor K3.1 Pro, geraadpleegd 23 oktober 2026.
Op 4 november is te controleren of de aangekondigde modelgewichten er zijn. Voor een overstap op je dagelijkse werk telt vooral of onafhankelijke metingen en je eigen vergelijking de gepubliceerde voordelen bevestigen.