AI robot: eerste plek is geen zekerheid
AI robot GPT-6.2 Astra leidt op SO-101, maar de foutmarges overlappen. Vergelijk DCR, gewonnen proeven en thuisgebruik met de interactieve leeshulp.
21 november 2026
GPT-6.2 Astra staat bovenaan een ranglijst voor de AI robot SO-101. Toch overlappen de foutmarges met nummer twee. En Claude Opus 5.5 heeft meer gewonnen vergelijkingen. Wie alleen de eerste plaats deelt, laat precies de cijfers weg die de uitslag begrijpelijk maken.
De AI robot wint geen wedstrijd met één cijfer
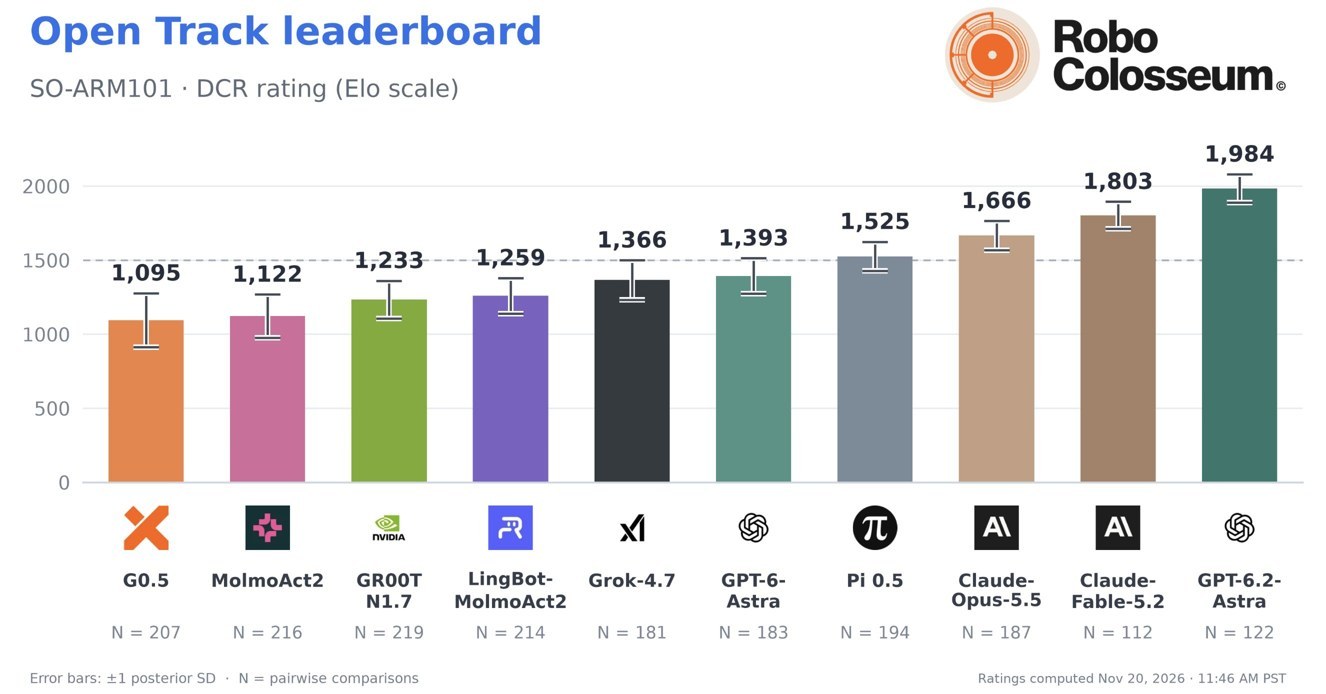
Het SO-ARM101 Open track van RoboColosseum zet GPT-6.2 Astra op 1.984 DCR. Claude Fable 5.2 volgt met 1.803. DCR schat het vermogen om taken af te maken, gecorrigeerd voor de geschatte moeilijkheid. Het is geen percentage en ook geen reeks gewone Elo-updates.
Het oorspronkelijke robotboard van RoboColosseum (21 november 2026) toont daarnaast gewonnen, gelijke en verloren vergelijkingen. Die bepalen de DCR-volgorde niet. Een menselijke beoordelaar vergelijkt twee uitvoeringen van dezelfde instructie in dezelfde omgeving, zonder te weten welk model welke uitvoering leverde.
| Model | DCR en vergelijkingen |
|---|---|
| GPT-6.2 Astra | 1.984 ±96 · 122 |
| Claude Fable 5.2 | 1.803 ±91 · 112 |
| Claude Opus 5.5 | 1.666 ±99 · 187 |
| π0.5 | 1.525 ±99 · 194 |
| GPT-6 Astra | 1.393 ±120 · 183 |
| Grok 4.7 | 1.366 ±134 · 181 |
| LingBot-MolmoAct2 | 1.259 ±120 · 214 |
| GR00T N1.7 | 1.233 ±127 · 219 |
| MolmoAct2 | 1.122 ±146 · 216 |
| G0.5 | 1.095 ±182 · 207 |
Welke claim past bij deze robotproef?
Kies een model en de conclusie die je wilt delen. De leeshulp gebruikt deze momentopname van het board; hij voorspelt geen nieuwe taken en berekent geen eigen DCR-score.
98 overwinningen maken Opus geen koploper
Claude Opus 5.5 heeft 98 overwinningen, Astra 95. Maar Opus deed ook mee aan 187 vergelijkingen, Astra aan 122. De ruwe aantallen vergelijken alsof beide evenveel kansen kregen, is misleidend. Bovendien rangschikt DCR taakvoltooiing na correctie voor moeilijkheid, niet deze overwinningen.
De uitslagen zijn respectievelijk 98 gewonnen, 57 gelijk en 32 verloren voor Opus; 95 gewonnen, 18 gelijk en 9 verloren voor Astra. Het onderscheid tussen een overtuigend antwoord en een bewezen vermogen hoort ook bij AI-geletterdheid.
Een eerste plek is geen bewijs voor thuis
De claim dat Astra duidelijk beter is dan Fable gaat verder dan het board. Astra’s band loopt van 1.984 − 96 = 1.888 tot 1.984 + 96 = 2.080. Fable loopt van 1.803 − 91 = 1.712 tot 1.803 + 91 = 1.894. Die banden overlappen. Het board noemt de voorsprong zelf binnen de foutmarges.
Dat maakt de meting niet waardeloos. Echte robotproeven laten zien waar een model vastloopt. De RoboColosseum-paper van 2 november 2026 beschrijft blinde vergelijkingen en zwakke overeenkomst tussen ranglijsten op verschillende robots. Een andere grijper, taak of omgeving kan dus een andere winnaar opleveren. Dat één model overal het beste is, hoort bij de AI-mythes die een goede test juist moet doorprikken.
Verder trainen is opnieuw een andere vraag. De paper vindt verschuivingen tussen Open track en Fine-tune track. Het verschil tussen trainen en uitvoeren staat ook in Hedra Model Factory: trainen of uitvoeren. De basis lees je bij hoe werkt AI.
Vergelijken zonder aanpassing aan de specifieke taak.
Vergelijken na training met gedeelde demonstraties per taak.
Blijft Astra voor na nieuwe robotproeven?
Sla vóór je dit leaderboard deelt of nabouwt de volledige rij op, inclusief robot, track, aantal vergelijkingen en foutmarge. Kijk bij een volgende verversing of de bandbreedtes smaller worden en of dezelfde taken en omstandigheden worden vergeleken. Alleen een hogere teller maakt een thuisrobot nog niet betrouwbaar.
- Bewaar de context. SO-ARM101, Open track, 21 november 2026.
- Vergelijk dezelfde maat. Zet DCR naast DCR, geen overwinning naast een voltooide taak.
- Test je eigen taak. Leg vooraf vast wat slagen, falen en veilig stoppen is.
WatisAI legt wat is AI uit vanuit wat aantoonbaar werkt. OrcaRouter, 21 november 2026, was de aanleiding voor deze vergelijking; de tabelwaarden en definities hierboven zijn gecontroleerd op het oorspronkelijke board. De paper beschrijft de eerdere studie en bewijst niet afzonderlijk Astra’s nieuwe score.
Deel de score mét robot en track
1.984 DCR geldt voor SO-ARM101 Open track. Controleer welke conclusie erbij past.
Naar de leeshulp