Nemotron Transcribe: sprekers goed, namen fout
Nemotron Transcribe transcribeert ook wie wat zegt. Onze Kamerdebat-test: alle 21 controleerbare segmenten klopten, de namen niet. Plus een prompt-maker.
29 oktober 2026
Nvidia bracht woensdag 28 oktober Nemotron 3.5 Transcribe uit: een open model dat spraak naar tekst omzet in 40 talen en er ook bijhoudt wie wat zegt. We lieten het diezelfde avond een fragment Kamerdebat uitschrijven, vier sprekers die door elkaar heen praten. Van de 23 segmenten die het model maakte, waren er 21 aan het stenogram te koppelen en kregen ze stuk voor stuk de juiste spreker. De namen gingen wél mis: Kamerlid Zalinyan (PRO) heette in de uitvoer Salignac, Saligna en Salignan, en chemiebedrijf Chemours viel als “geen moer”.
Nieuw met dit onderwerp? Bij wat is AI lees je de basis. Hieronder staat de hele test en een gereedschap dat je transcriptieprompt in elkaar zet.
We lieten het een Kamerdebat uitschrijven
Het fragment komt uit het plenaire debat over de begroting van Infrastructuur en Waterstaat, woensdag 28 oktober tussen 11:49 en 11:52. Kamerlid Zalinyan (PRO), Van der Plas (BBB), Teunissen (PvdD) en voorzitter Van Campen praten in 169 seconden pfas-aanpak door, met korte interrupties achter elkaar. We draaiden de opname door de openbare demo van het model met de preset voor sprekerlabels en legden de uitvoer naast het ongecorrigeerde stenogram van de Kamer.
Stenogram · Van der Plas (BBB), 11:49
“Dan kom ik ook nog even terug op de luchtkwaliteit. Daar maakt mevrouw Zalinyan zich ook grote zorgen over. … Hoe rijmt mevrouw Zalinyan dat met haar opmerking dat iedereen ziek wordt en de luchtkwaliteit slecht is?”
Model · spk:2
“Ja, sorry, voorzitter, dan kom ik ook nog even terug op de eh luchtkwaliteit. Ehm, daarvan zegt mevrouw Salignac ook van, nou ja, de grote zorgen. … Hoe ruimt mevrouw Salignac eh dat …”
Stenogram · Zalinyan (PRO), 11:50
“Mevrouw Van der Plas vindt het denk ik jammer dat ik haar woorden niet ga hergebruiken, omdat ze nog even sterker zouden aankomen door ze te herhalen. …”
Model · spk:0
“Mevrouw Van der Plas, ik denk het jammer dat ik haar woorden niet herbruik zodat ze het herhaalt dat het nog even sterker”
Stenogram · de voorzitter, 11:50
“Afrondend.”
Model · spk:1
“Afrondend.”
Stenogram · Van der Plas (BBB), 11:50
“Ik snap niet dat iedereen helemaal bang wordt van het woord ‘porno’. Dat is gewoon een heel normaal Nederlands woord, dus …”
Model · spk:2
“Ja, voorzitter, ik snap niet eens iedereen een een hele bang woord van het woord porno, is gewoon een heel normaal Nederlands woord. Dus eh.”
Stenogram · Van der Plas (BBB), 11:51
“Joh, we zijn geen suikerklontjes!”
Model · spk:2
“Joh, we zijn geen eh.” en, na twee korte tussenwerpsels van de voorzitter: “Er zijn geen suikerklontjes eh, zeg af en toe”
Stenogram · Teunissen (PvdD), 11:51
“Mevrouw Zalinyan moest haar betoog afbreken toen ze net over pfas begon, terwijl ik het daar ook echt interessant begon te vinden. … Vindt mevrouw Zalinyan ook dat we … ook gewoon een nationaal lozingsverbod moeten hebben …?”
Model · spk:3
“mevrouw Saligna moest haar betoog afbreken toen ze net over PFAS begon, terwijl ik daar ook echt interessant rond vond begon vinden. … een nationaal losingsverbod moeten hebben en ook een verbod op de import …”
Stenogram · Zalinyan (PRO), 11:51
“… Het is namelijk niet meer te verantwoorden naar alle mensen en ook niet naar alle mensen die rondom Chemours wonen. …”
Model · spk:0
“… omdat het niet meer te verantwoorden is naar al die mensen en ook naar alle mensen die eh rondom geen moer wonen.”
Eén fragment is geen benchmark
Dit is één fragment van 169 seconden uit één debat, gedraaid met temperatuur 0 via de gratis demo. Het model sneed het fragment in 4 sprekers en 23 segmenten; het stenogram telt er 12, met interrupties die in de audio door elkaar lopen. Van de 23 segmenten waren er 21 aan het stenogram te koppelen en kregen ze allemaal de juiste spreker, ook de acht korte wisselingen achter elkaar tussen Van der Plas en de voorzitter. Twee tussenwerpsels (“Zeker.”, “Ja.”) staan nergens in het stenogram en konden we niet controleren. De volledige controle staat in de tabel hieronder.
Een foutpercentage rekenen loopt vast: het stenogram is geredigeerd, het model schrijft woordelijk met “eh”, “nou ja” en herhalingen. Wat we wel kunnen zeggen: de inhoud van elke beurt is herkenbaar. De namen gingen wél mis: alle 6 vermeldingen van Zalinyan, verspreid over 4 segmenten, stonden er als Salignac, Saligna of Salignan; Van der Plas kreeg bij drie noemingen één keer de juiste naam, de andere twee keren “Martin Plas” en “Zonder van plas”; en chemiebedrijf Chemours werd “geen moer”. Verder: “rijmt” werd “ruimt”, “laks” werd “lax”, “lozingsverbod” viel één keer goed en één keer als “losingsverbod”, en één zin van Teunissen raakte verhaspeld.
De tweede run met die namen als context in de prompt konden we niet draaien: het gratis demokotum was na één run op, met de melding dat de volgende poging pas na bijna 24 uur kon. Of een contextprompt onze namenfouten had weggehaald, hebben we dus niet zelf gemeten. NVIDIA mat dat effect wel, in het Engels: de fout op eigennamen zakte van 12,21 naar 2,20 procent zodra de modelkaart namen als context meekreeg.
Beurt voor beurt: alle 23 modelsegmenten naast het stenogram
| Seg. | Model | Spreker volgens stenogram | Begin van de tekst | Controle |
|---|---|---|---|---|
| 1 | spk:0 | Zalinyan, 11:49 | “Niet natuurlijk is. Dus elke PFAS…” | klopt |
| 2 | spk:1 | voorzitter, 11:49 | “Martin Plas.” | klopt, naam fout |
| 3 | spk:2 | Van der Plas, 11:49 | “Ja, sorry, voorzitter, dan kom ik…” | klopt |
| 4 | spk:1 | voorzitter, 11:50 | “Mevrouw Salignac.” | klopt, naam fout |
| 5 | spk:0 | Zalinyan, 11:50 | “Mevrouw Van der Plas, ik denk het jammer…” | klopt |
| 6 | spk:1 | voorzitter | “Zeker.” | niet in stenogram |
| 7 | spk:0 | Zalinyan, 11:50 | “Aankomt, maar ik houd eventjes hierbij.” | klopt |
| 8 | spk:1 | voorzitter, 11:50 | “Afrondend.” | klopt |
| 9 | spk:2 | Van der Plas, 11:50 | “Ja, voorzitter, ik snap niet eens…” | klopt |
| 10 | spk:1 | voorzitter, 11:50 | “Ja, maar mensen die wat visueel zijn…” | klopt |
| 11 | spk:2 | Van der Plas | “Ja.” | niet in stenogram |
| 12 | spk:1 | voorzitter, 11:51 | “Misschien. Inclusief” | klopt |
| 13 | spk:2 | Van der Plas, 11:51 | “Joh, we zijn geen eh.” | klopt |
| 14 | spk:1 | voorzitter, 11:51 | “Inclusief ondergetekende.” | klopt |
| 15 | spk:2 | Van der Plas, 11:51 | “Er zijn geen suikerklontjes eh…” | klopt |
| 16 | spk:1 | voorzitter, 11:51 | “Dat is” | klopt |
| 17 | spk:2 | Van der Plas, 11:51 | “Zeg maar, maar we kunnen” | klopt |
| 18 | spk:1 | voorzitter, 11:51 | “Zonder van plas.” | klopt, naam fout |
| 19 | spk:2 | Van der Plas, 11:51 | “Eh, nou, dat wou ik eigenlijk nog even zeggen.” | klopt |
| 20 | spk:1 | voorzitter, 11:51 | “Ja. Mevrouw Teunissen.” | klopt |
| 21 | spk:3 | Teunissen, 11:51 | “Ja, voorzitter, mevrouw Saligna moest…” | klopt, naam fout |
| 22 | spk:1 | voorzitter, 11:51 | “Mevrouw Salignan.” | klopt, naam fout |
| 23 | spk:0 | Zalinyan, 11:51 | “Wij vinden dat er een nationaal verbod…” | klopt |
Het stenogram telt in dit fragment 12 spreekbeurten, met interrupties die in de audio door elkaar lopen; het model sneed dat uiteen in 23 segmenten. Tijden zijn de stenogramminuut van de bijbehorende beurt; de twee tussenwerpsels hebben geen stenogramtijd. De voorzitterssegmenten met een roepnaam (“Martin Plas.”, “Mevrouw Salignac.”, “Zonder van plas.”, “Mevrouw Salignan.”) geven de beurtaanwijzing weer die het stenogram bij de volgende spreker verwerkt; de achternamen daarin zijn de fouten die hierboven bij de namen staan.
Wat belooft NVIDIA voor het Nederlands?
De modelkaart geeft Nederlands voor transcriberen en vertalen naar Engels het label “Leading”, met 3,75 procent fout op de FLEURS-tests en gemiddeld 5,96 procent op het meertalige leaderboard. Sprekerlabels staan voor Nederlands niet in de matrix: “niet gespecificeerd”. Officieel ondersteunt het model ze in 13 andere talen, met maximaal 8 sprekers. Onze test was dus precies het gat in de matrix, en in dit fragment vulde het model dat gat gewoon in.
Wisselen tussen Nederlands en Engels in één opname staat wel als ondersteund. Vragen stellen over de audio kan volgens NVIDIA alleen betrouwbaar in het Engels; voor andere talen waarschuwt de kaart dat dat “onbetrouwbaar kan zijn”.
| Taal | Transcriberen | Vertalen EN | Sprekerlabels | Taal wisselen | Kwaliteit |
|---|---|---|---|---|---|
| Nederlands | ja | ja | niet gespecificeerd | ja | Leading |
| Engels | ja | ja | ja, max. 8 sprekers | ja | Leading |
Is Nemotron Transcribe echt de beste?
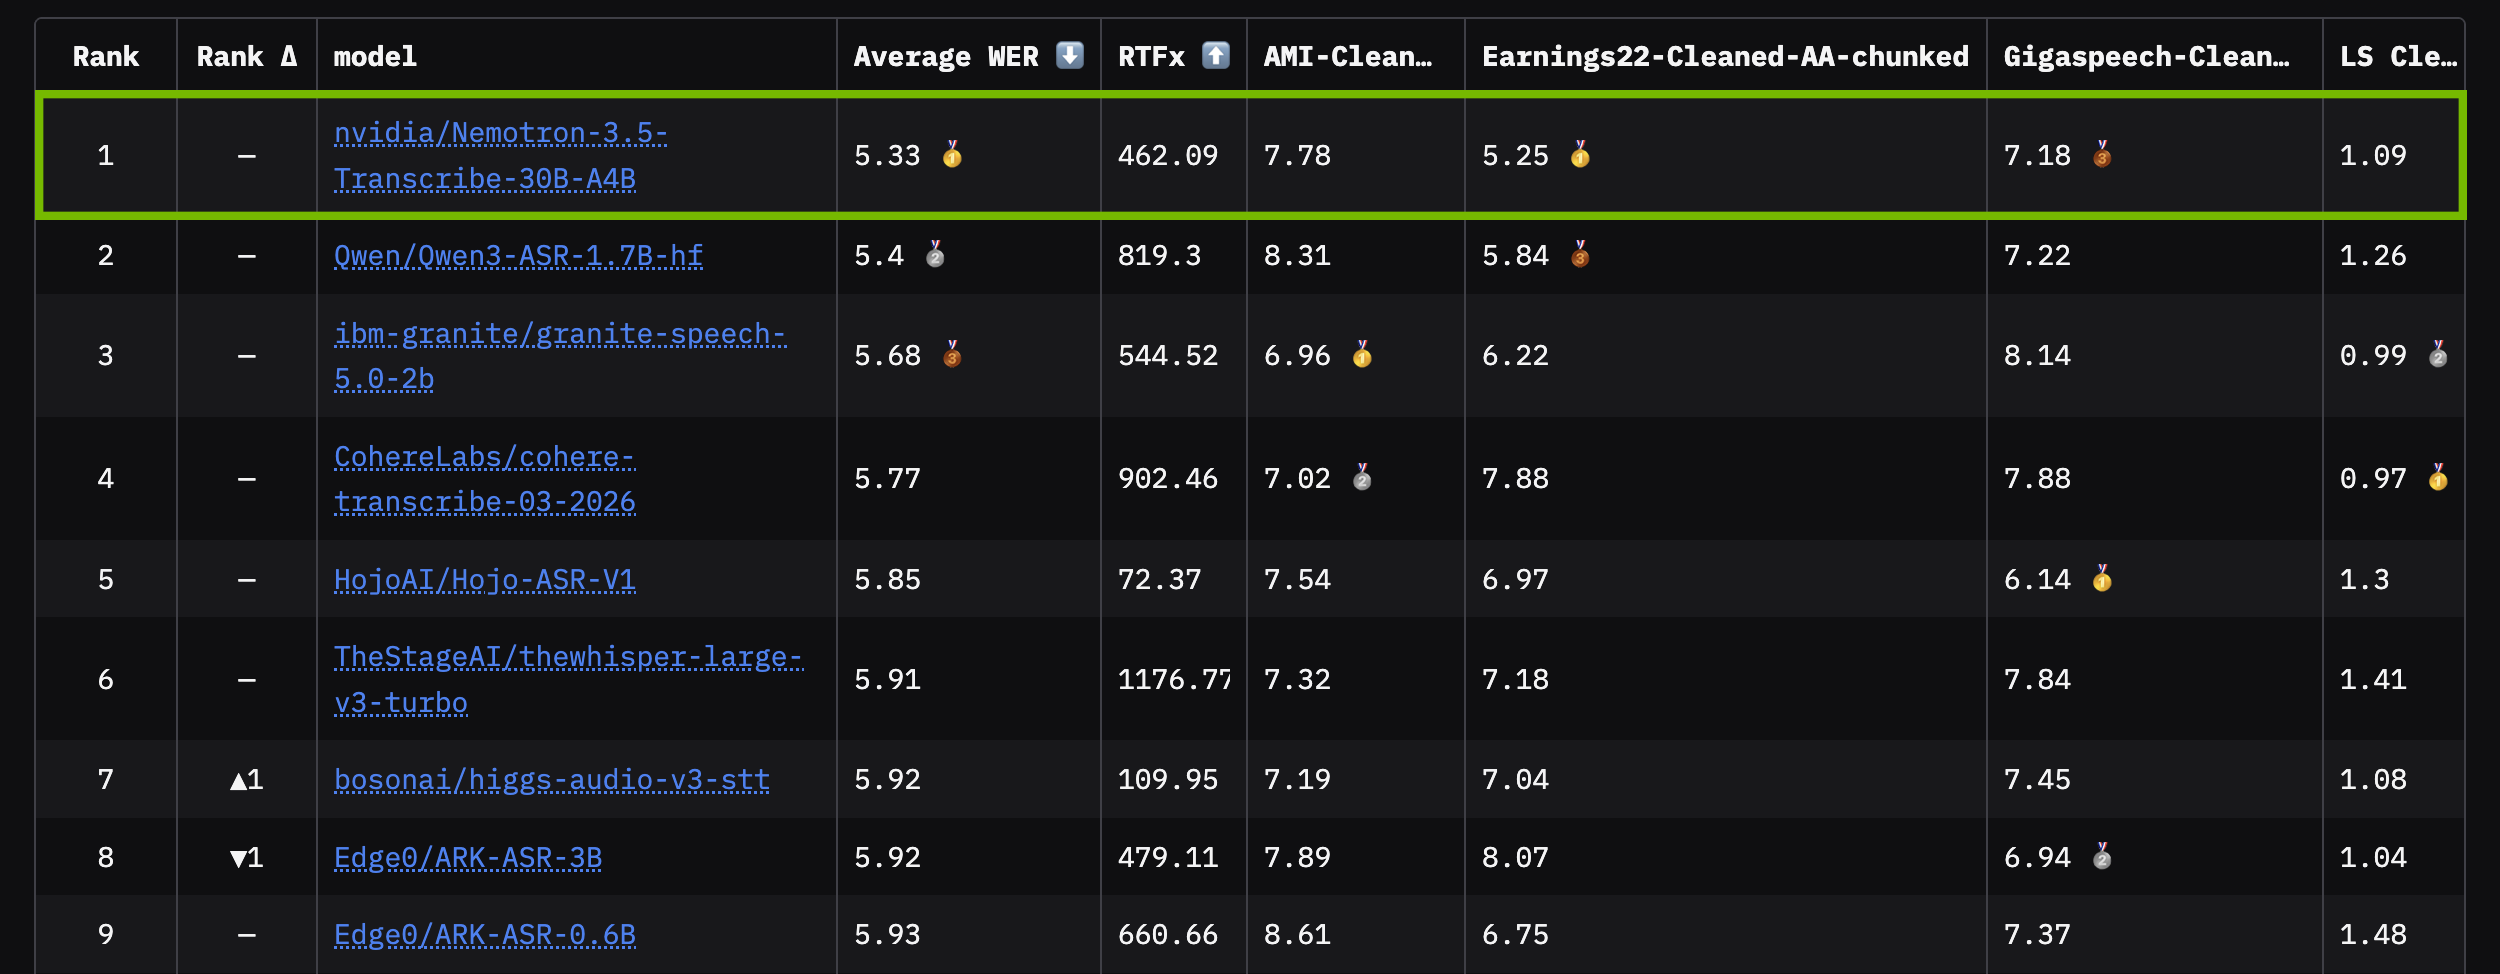
Bij de lancering, 28 oktober, stond het model bovenaan het Engelstalige Open ASR Leaderboard met gemiddeld 5,33 procent fout, en nummer twee, Qwen3-ASR-1.7B, stond toen op 5,40: een verschil van 0,07 punt voor een model dat ongeveer achttien keer kleiner is en sneller uitleest (819 tegenover 462 realtimefactoren). Whisper large v3 turbo volgde op 5,91. De modelkaart zelf noemt inmiddels recentere cijfers, 4,71 tegenover 4,94 voor Qwen, maar het beeld blijft hetzelfde: geen overmacht, een dunne voorsprong.
En bovenaan een Engels leaderboard zegt niets over jouw Nederlandse vergadering. Daarvoor staat hieronder de eigen test.
Vier miljard actief is geen lichte laptop
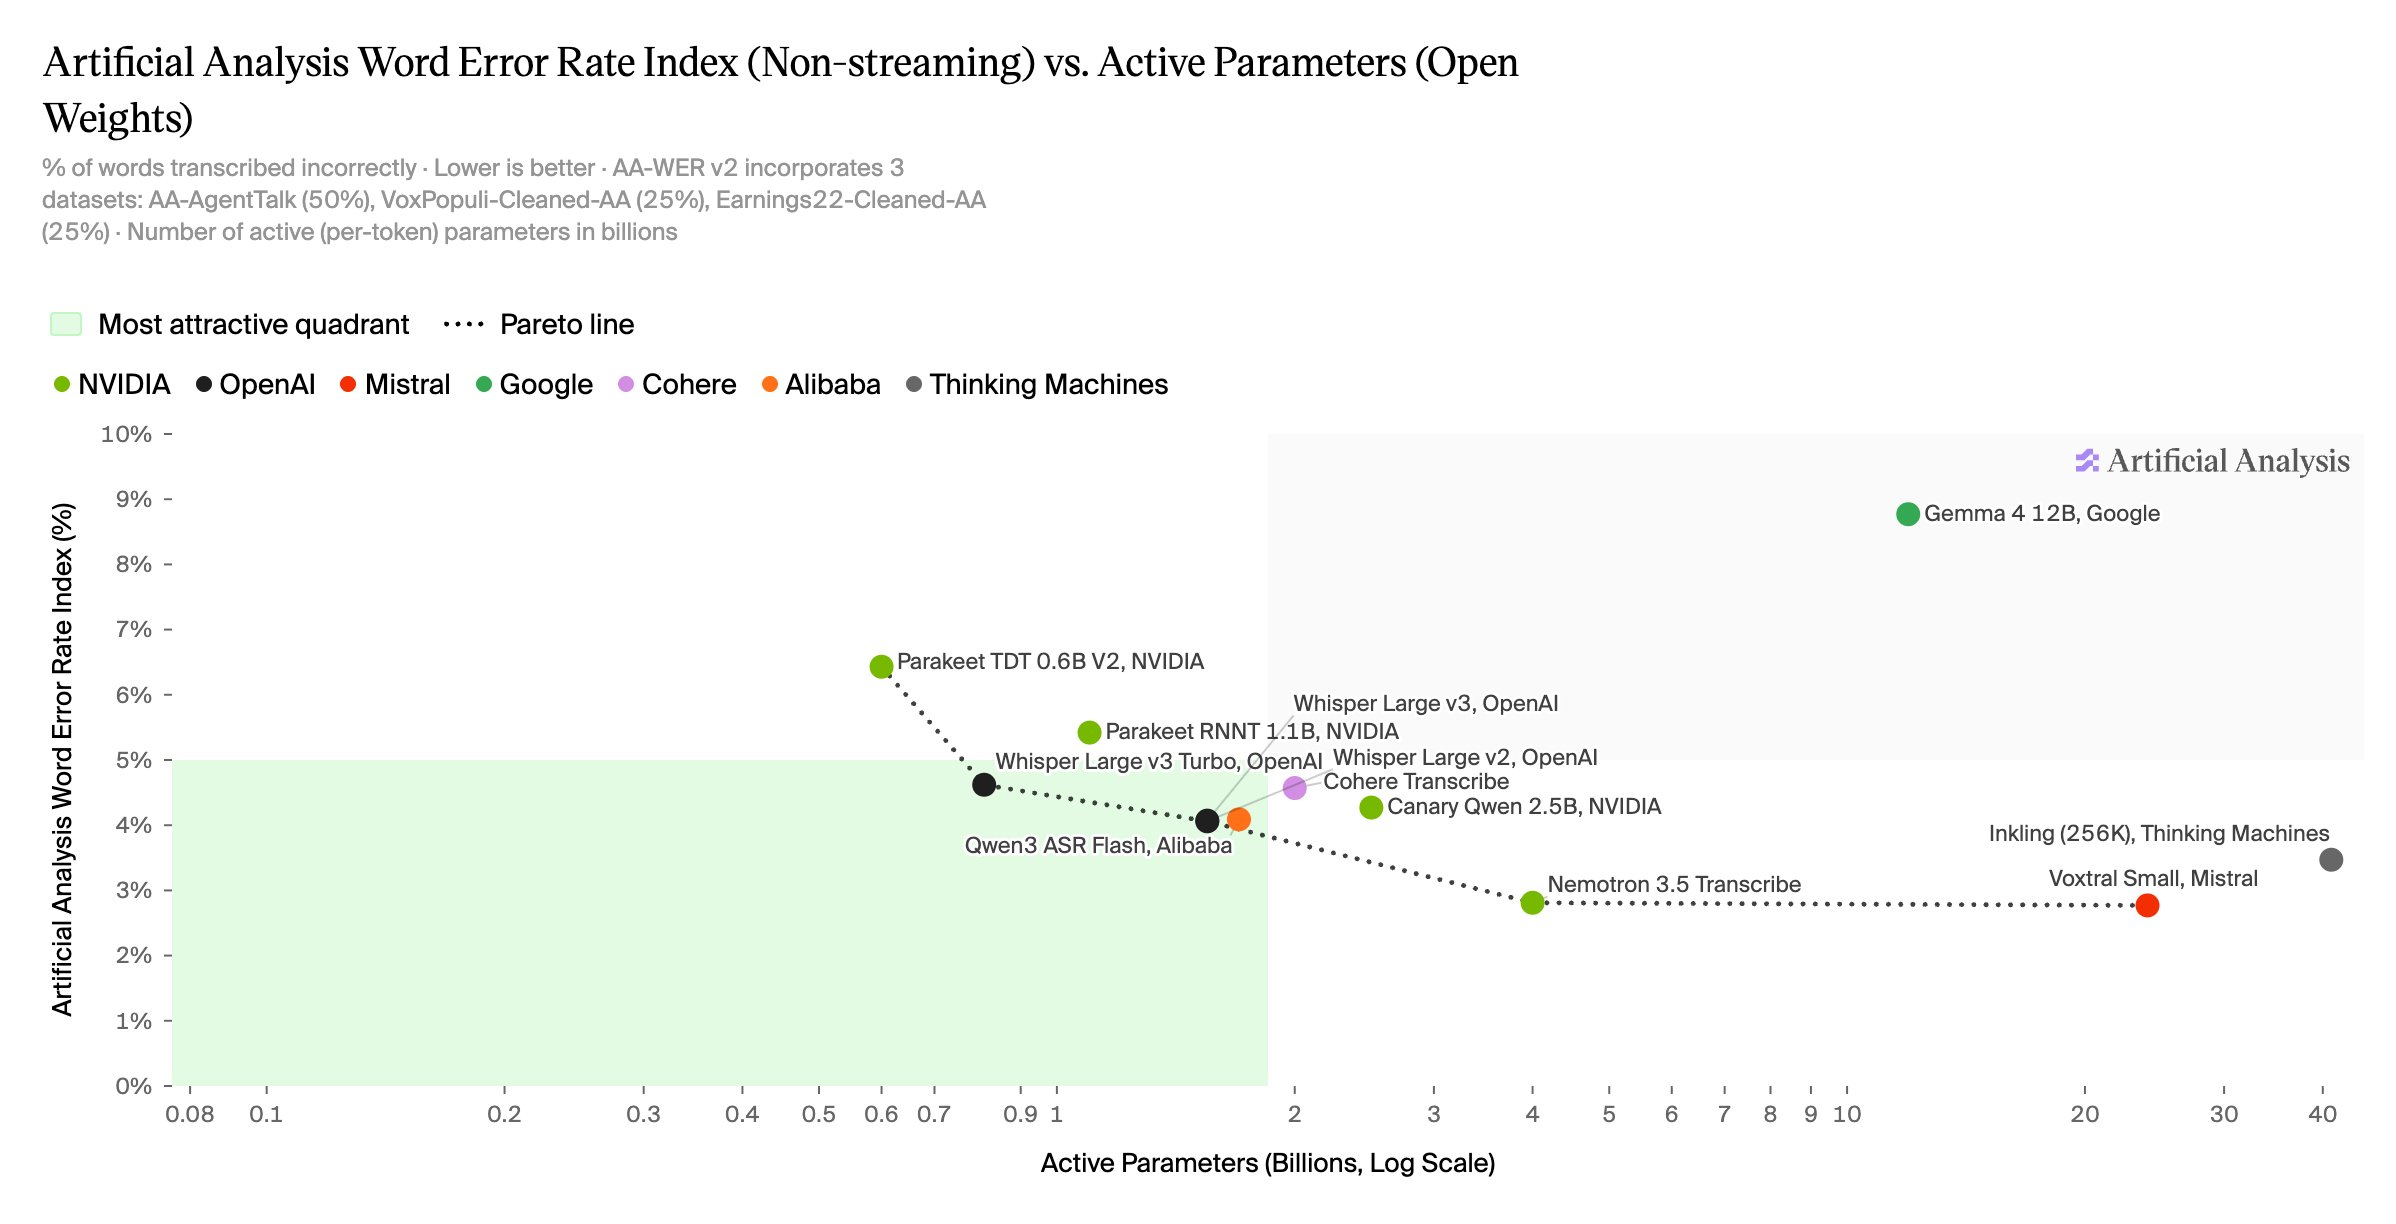
De Artificial Analysis-vergelijking zet het foutpercentage uit tegen actieve parameters: Nemotron haalt 2,81 procent met zo’n 4B actief, Voxtral Small 2,77 procent met 24B actief, Whisper large v3 rond de 4 procent. Maar 4B actief is geen 4B geheugen: alle 34 miljard gewichten moeten in het geheugen staan, daarom vraagt NVIDIA nu een H100 met 80 GB. Bij Kolibri 1: 3B actief is geen 3B geheugen legden we eerder uit hoe dat verschil werkt; hier geldt precies hetzelfde.
De diarisatieprijs komt van David AI, en de trainingsdata deels ook
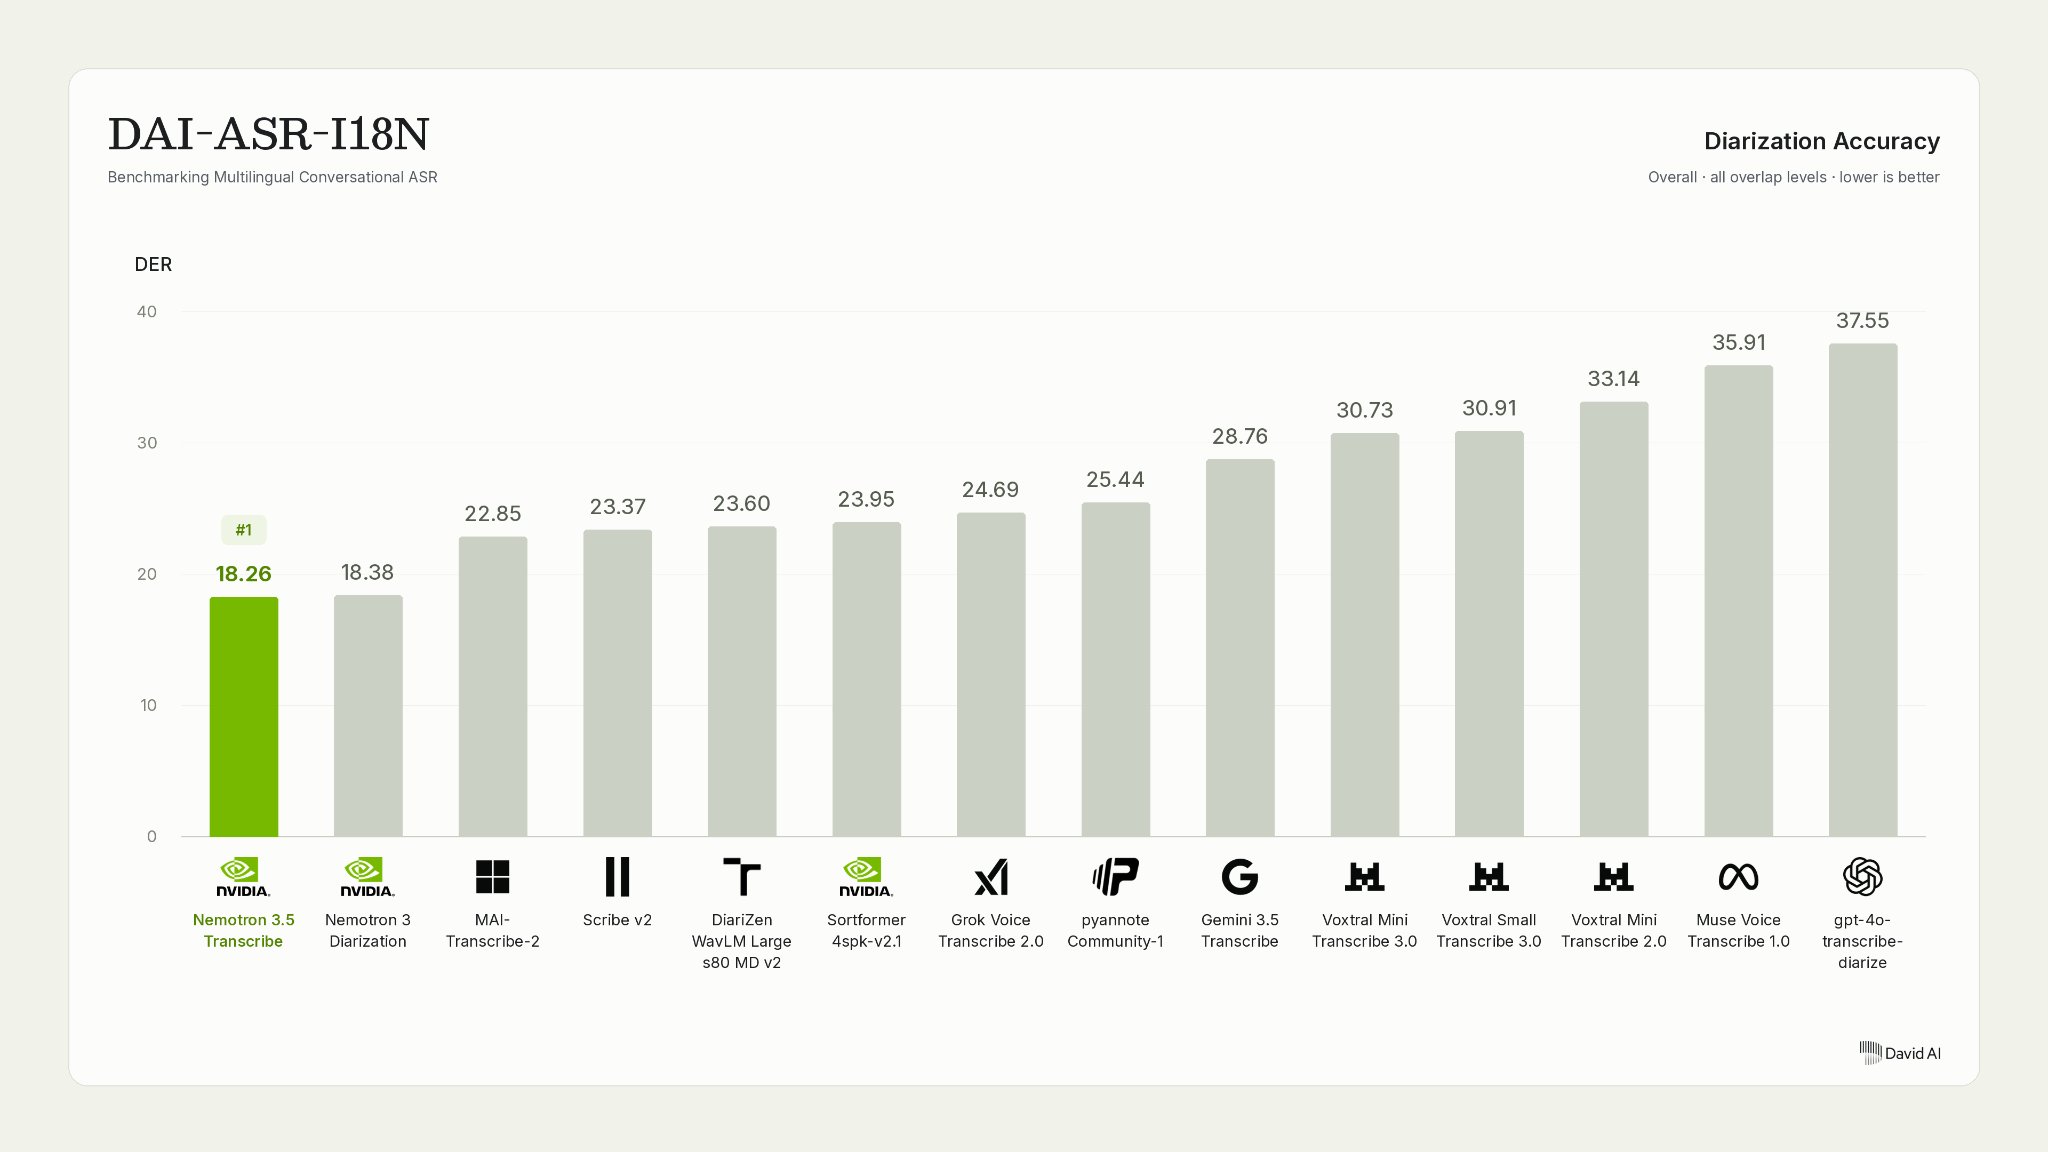
De sterkste grafiek van de lancering meet wie-zei-wat-fouten: Nemotron 3.5 Transcribe staat met 18,26 bovenaan, net boven NVIDIAs eigen Nemotron 3 Diarization (18,38) en ruim boven MAI-Transcribe-2 (22,85). Twee kanttekeningen horen erbij. De toets komt van David AI, en het model is getraind op data die David AI aan NVIDIA licentieerde; volgens NVIDIA zat de toetsset zelf niet in die trainingsdata. En in de demovideo van NVIDIA zelf wezen X-gebruikers op toewijzingen die niet klopten: meerdere labels voor één stem en een vierde spreker die nauwelijks verscheen (reactie op X, 28 oktober 2026). In ons Kamerfragment zagen we dat niet: daar zaten de vier toewijzingen allemaal goed.
Kun je Nemotron Transcribe zelf gebruiken?
De openbare demo draait gratis en zonder account en verwerkte ons fragment in ruim 50 seconden rekentijd, ongeveer een minuut inclusief wachtrij. Maar het quotum is krap: na één run van een paar minuten audio kregen we de melding dat de volgende poging pas na bijna 24 uur kon. Clips tot ongeveer vijf minuten passen erin.
Op je eigen server kan dat al: de compatibiliteitstabel in de modelkaart noemt BF16, FP8 en NVFP4 voor een DGX Spark en een Jetson Thor, en de BF16-referentie is getest op een H100 met 80 GB. De snelle serveerroute van NVIDIA zelf zit niet in de open release, de open vLLM-route is ongeveer twee keer langzamer. Wat het lokaal draaien van een open model verder vraagt, staat bij Meta geeft weer een AI-model weg: wat Muse Glimmer op je eigen laptop doet.
Wie audio wil transcriberen zonder zelf te installeren, huurt rekenkracht in: een gehoste dienst rekende op 28 oktober $0,002 per minuut audio, een uur vergadering kost dus ongeveer $0,12. Wel een beperking: DeepInfra meldde op 28 oktober dat sprekerherkenning in zijn API nog niet beschikbaar was, dus voor wie-zei-wat blijf je voorlopig op de demo of een eigen server aangewezen. De licentie (OpenMDW, van de Linux Foundation) staat in gewone taal: gratis gebruiken, ook commercieel; verspreid je het model zelf, dan horen de licentie- en herkomstvermeldingen erbij. Zonder garantie, en de rechten van anderen regel je zelf.
Die laatste regel telt: een opname van een vergadering staat vol persoonsgegevens. Vraag deelnemers vooraf of je mag opnemen. Lokaal draaien houdt de audio op je eigen machine; via een demo of gehoste dienst verlaat hij je huis. Meer staat bij AI en privacy: wat gebeurt er met je gegevens?
Gratis, geen account, ongeveer één run van een paar minuten per dag.
BF16, FP8 en NVFP4 op DGX Spark en Jetson Thor; BF16-referentie getest op een H100 (80 GB).
$0,002 per minuut audio, prijs 28 oktober 2026; sprekerlabels bij lancering nog niet in de API.
Zet de namen erbij: de Transcriptieprompt-maker
In de reacties op X was dit precies wat gebruikers wilden: een prompt waarin je vooraf de namen en vaktermen meegeeft en de opruimronde achteraf overslaat. De hulp hieronder zet de instructie van de modelkaart voor je klaar met jouw taal, sprekers, namen, stijl en lengte, en zegt er eerlijk bij wat je kunt verwachten.
Het model herkent de taal zelf; deze keuze past de verwachting hieronder aan, niet de prompt.
Prompt voor het model
Tweede prompt, apart sturen
Eigen hulpmiddel, versie 28 oktober 2026, op basis van de modelkaart van NVIDIA en onze test. Er wordt niets verstuurd of bewaard.
Whisper maakte transcriberen al gratis
Transcriberen met AI is geen nieuw fenomeen. OpenAI gaf in september 2022 Whisper weg, een open model getraind op 680.000 uur audio, en daarmee werd gratis uittranscriberen normaal. NVIDIAs eigen Parakeet en Canary stonden in 2024 en 2025 bovenaan het Open ASR Leaderboard. Mistral bracht in juli 2025 Voxtral uit, het eerste bekende promptbare open spraakmodel: je kon de uitleg sturen die je wilde. Nieuw aan Nemotron 3.5 Transcribe is de bundel: transcriberen, sprekerlabels, vertalen en context in één open model. In de gesloten assistenten bestaat dat al langer: in ChatGPT kun je live een gesprek voeren dat de bot tegelijk volgt en beantwoordt.
Test hem deze week op een eigen fragment
- Knip twee minuten uit een eigen of openbare opname met minstens twee sprekers door elkaar. Hoe meer interrupties, hoe zinniger de test.
- Zet de namen en vaktermen in de Transcriptieprompt-maker hierboven en plak de prompt in de demo of op je eigen server. Stuur de vertaalprompt, als je die hebt, apart mee.
- Leg de uitvoer naast je eigen notities en check eerst namen, bedragen en ontkenningen; dat zijn de fouten die een zin omdraaien.
De drempel om zelf te draaien zakt: volgens de compatibiliteitstabel in de modelkaart draaien alle drie de varianten (BF16, FP8 en NVFP4) op een DGX Spark of Jetson Thor; de H100 met 80 GB is de geteste referentie, geen vereiste. Staat Nederlands daarna ook in de sprekersmatrix, dan verdwijnt de grootste onzekerheid uit onze test vanzelf uit de kaart. Tot die tijd beslist de eigen proef, want de benchmark van een ander bewijst niet dat jouw vergadering er doorheen komt.
Bronnen, gecontroleerd op 28 oktober 2026: de aankondiging met demovideo van NVIDIA op X, de modelkaart en blog voor Nemotron 3.5 Transcribe op Hugging Face, het ongecorrigeerde stenogram van de plenaire vergadering van 28 oktober (Tweede Kamer), de prijspagina van DeepInfra, berichten van The New Stack en The Decoder van 28 oktober, en de reacties op X bij de aankondiging. De leaderboard- en diarisatiegrafieken komen uit die X-post en dragen de data van Hugging Face, Artificial Analysis en David AI.
Eén fragment uit jouw week, de namen erbij, het verschil op tafel
Heb je deze week een vergadering? Neem twee minuten, zet de namen in de prompt-maker en vergelijk de uitvoer met je eigen notities.
Open de Transcriptieprompt-maker