18 oktober 2026
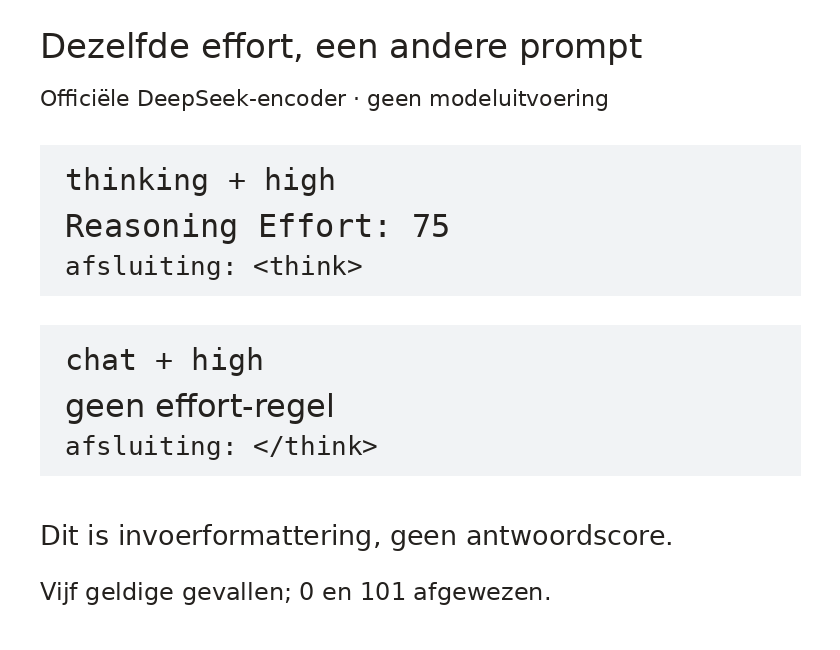
De officiële encoder van DeepSeek V4.1 zette high in onze proef om in reasoning effort 75. In chatmodus verdween die effort-regel uit de prompt, ook al gaven we dezelfde instelling mee. Alleen de juiste modelnaam kiezen is dus niet genoeg om dezelfde invoer te bouwen.
Bij de 1017-versie van DeepSeek V4.1 begint een eerlijke vergelijking bij het berichtformaat. Anders vergelijk je mogelijk twee verschillende opdrachten en noem je het verschil ten onrechte modelkwaliteit.
DeepSeek V4.1 verwijst naar een Python-encoder
De officiële modelkaart verwijst voor het promptformaat naar een zelfstandige Python-encoder en deepseek-recipe. Ga dus niet blind uit van de chattemplate die een andere modelversie of je bestaande wrapper gebruikt.
We draaiden de vastgelegde 1017-encoder op kleine, vastgelegde berichten. De bronversie was revision 1bae0e1088993b9b82de08f59de5be5a34e42170. Er zijn geen modelgewichten gedownload en er is geen antwoord door DeepSeek gegenereerd.
De encoder was byte voor byte gelijk aan die van de eerdere V4.1-Flash-versie. Het formaat is dus geen nieuwe 1017-wijziging. Deze proef is praktische protocoluitleg voor wie met 1017 werkt; hij stelt geen nieuw verschil tussen die twee modellen vast.
| Modus | Meegegeven effort | Zichtbaar resultaat van de encoder |
|---|---|---|
| Thinking | low |
Reasoning Effort: 50 |
| Thinking | high |
Reasoning Effort: 75 |
| Thinking | max |
Reasoning Effort: 100 |
| Thinking | Getal 1 |
Reasoning Effort: 1 |
| Chat | high |
Geen effort-regel; andere afsluiting van de assistentprompt |
Dit is de volledige opgebouwde prompt voor ons thinking/high-geval, inclusief de eigen testtekst:
<|begin▁of▁sentence|><|System|>Reasoning Effort: 75 (range 1-100, the higher the value, the more thorough the reasoning)

Fixture only.<|User|>What is 2+2?<|Assistant|><think>
De woorden low en high zijn hier dus concrete omzettingen in deze encoder. Het zijn geen universele instellingen die bij iedere API hetzelfde doen.
In het vastgelegde thinking-bericht stond aan het begin van de systeemtekst Reasoning Effort: 75. Het assistentgedeelte eindigde op <think>. In chatmodus ontbrak de effort-regel en eindigde dat gedeelte op </think>. Dat zijn zichtbare verschillen in de werkelijk opgebouwde prompt.
Een formatteringsproef is nog geen AI-benchmark
We vinden een vergelijking zonder vastgelegd berichtformaat onvoldoende. Een tabel met mooie modelscores helpt je weinig wanneer jouw applicatie de invoer anders verstuurt dan de meegeleverde encoder verwacht.
Dat maakt deze kleine proef ook niet groter dan hij is. We hebben tekst opgebouwd en gecontroleerd, geen redeneervermogen gemeten. De vraag What is 2+2? stond als testinvoer in het bericht. Dat er een prompt ontstond, bewijst niet welk antwoord het model daarop zou geven.
| Controle | Werkelijk uitgevoerd | Niet aangetoond |
|---|---|---|
| Prompt opbouwen | Vijf geldige formatteringsgevallen | Betere antwoorden of lager tokengebruik |
| Grenzen van effort | 0 en 101 gaven AssertionError |
Foutafhandeling van een externe API |
| Completion uitlezen | Een vaste voorbeeldcompletion geparseerd | Correcte parsing van alle mogelijke modeluitvoer |
De meegeleverde completion-parser scheidde in onze vaste invoer de redeneertekst van de antwoordtekst. Ook dat is een protocolcontrole. Er heeft geen model geredeneerd tijdens deze proef.
Welke tekst ontvangt het model werkelijk?
Bewaar bij één geïsoleerde test de berichten én de uiteindelijke prompt die jouw encoder daarvan maakt. Vergelijk vooral de modus, systeemtekst, effort-instelling en afsluiting van het assistentgedeelte. Gebruik hiervoor geen klantgegevens of secrets.
De beschikbare bestanden van de modelversie maken zichtbaar welke formatteringscode bij die versie hoort. Koppel een eigen adapter aan een vastgelegde bronversie; main kan later veranderen.
Dat tekst voor een machine iets anders kan betekenen dan voor de lezer, zie je ook bij cloaken en context voor AI. Hier gaat het niet om verborgen inhoud, maar om de tekst die je eigen software toevoegt of weglaat voordat het model begint.
Een goede prompt schrijven gaat over de opdracht die je geeft. De encoder zet zulke berichten om naar het modelprotocol. Het opdelen in AI-tokens is weer een andere stap; die tokens hebben we hier niet geteld.
Bij een volgende modeltest hoort daarom eerst dezelfde prompt in beeld. Pas daarna kun je een verschil in antwoorden aan de modeluitvoering proberen toe te schrijven.
Begin je pas met deze modellen, dan legt Wat is AI de basistermen uit. Deze proef gaat alleen over het berichtformaat.