1 oktober 2026
Je krijgt een uitnodiging voor een onderzoek. Eén minuut videobellen met een andere deelnemer, over waar je dit jaar naar uitkijkt. De vrouw in beeld lacht en knikt terwijl jij praat. Pas aan het eind van de vragenlijst komt de vraag: kwam het bij je op dat zij geen mens was? Zo zag de turing test eruit waarmee Tavus donderdag naar buiten kwam.
De vrouw bestond niet. Ze was een gesprekspartner van Griffin-Lite, het nieuwe model van het Amerikaanse Tavus. Gezicht, stem en antwoorden ontstonden live. Van de 54 deelnemers dachten er 26 dat ze met een echt mens hadden gepraat. Dat is 48 procent.
Tavus zette het om 18.59 uur Nederlandse tijd op X met de zin “the first model to pass the video Turing test”. Rond 23.10 uur stond die post op 12.110 likes en ruim 3,5 miljoen weergaven.
Het vorige systeem van Tavus haalde in dezelfde proef 1 op de 41. De sprong is dus enorm. De vraag is alleen of “geslaagd” het goede woord is. Wij legden de cijfers naast elkaar en rekenden ze na.
Hoe werkt de turing test van Alan Turing eigenlijk?
Alan Turing beschreef in 1950 het “imitation game” in zijn artikel Computing Machinery and Intelligence. Een ondervrager praat via getypte berichten met twee partijen die hij niet ziet. In de vorm die nu gangbaar is, is één van de twee een mens en één een machine. De ondervrager moet kiezen wie wie is.
Turing voorspelde dat een gemiddelde ondervrager rond het jaar 2000 “not more than 70 per cent. chance of making the right identification after five minutes of questioning” zou hebben. De kern zit in die keuze: je vergelijkt een machine met een mens, en de beoordelaar weet dat hij moet zoeken.
Zo’n gangbare test is goed gedaan. In 2025 lieten onderzoekers Cameron Jones en Benjamin Bergen van UC San Diego mensen vijf minuten chatten met een mens en een AI tegelijk. Met een persona-instructie werd GPT-4.5 daar in 73 procent van de gevallen als de mens gekozen, blijkt uit hun studie. Dat was tekst, geen video, maar wel met een mens ernaast om mee te vergelijken.
In de proef van Tavus zat dat anders. Dit staat letterlijk in de onderzoeksbeschrijving:
| Onderdeel | Gangbare turing test | Tavus Griffin (2026) |
|---|---|---|
| Weet de beoordelaar dat er een machine kan zijn? | Ja, kiezen is de opdracht | Nee, ze dachten een deelnemer te treffen |
| Is er een mens om mee te vergelijken? | Ja, tegelijk | Nee, alleen de AI |
| Duur | Vijf minuten | Eén minuut |
| Wanneer valt de vraag? | Direct na het gesprek | Pas aan het eind van de vragenlijst |
| Medium | Tekst | Live video met stem |
Een ondervrager die niet weet dat hij moet zoeken, zoekt niet. Tavus schrijft zelf dat meer dan de helft van de deelnemers er tijdens het gesprek niet eens aan dacht. Bijna al die mensen zeiden daarna dat hun partner echt was.
26 van 54 heeft een marge van 35 tot 61 procent
Met 54 mensen is 48 procent geen scherp getal. Wij rekenden het betrouwbaarheidsinterval uit, met de Wilson-methode die voor kleine groepen geschikt is. Bij 95 procent zekerheid ligt het echte aandeel ergens tussen 35 en 61 procent.
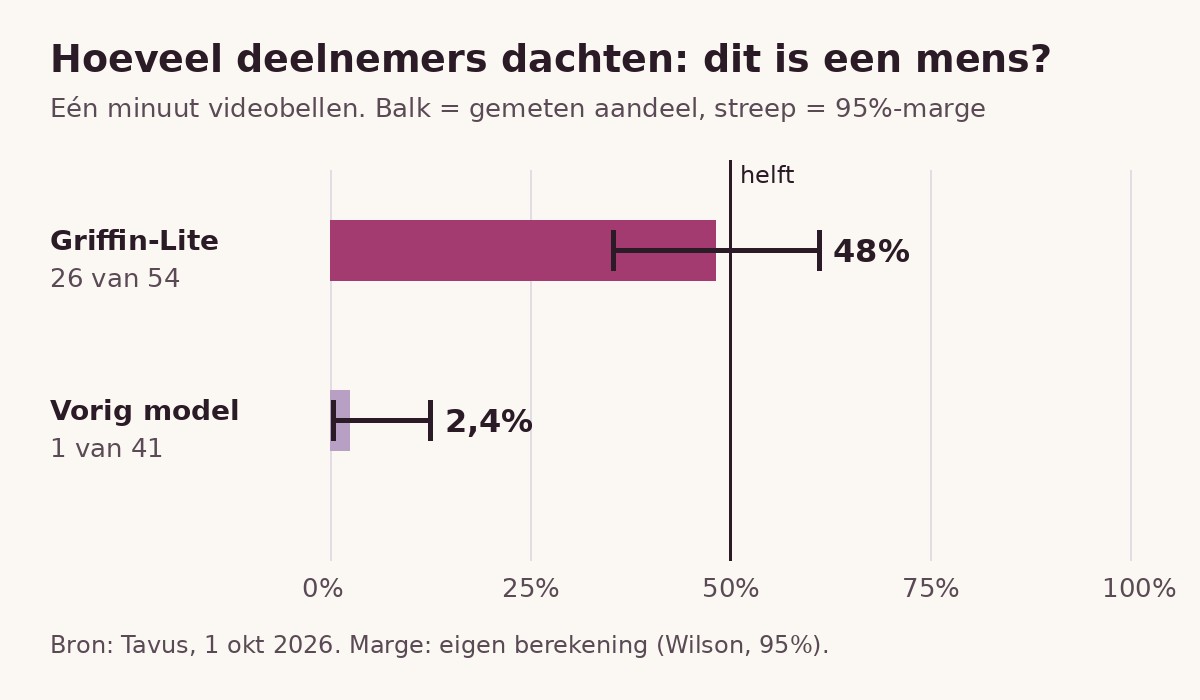
Was het één persoon minder geweest, dan stond er 46 procent. Twee mensen meer en Tavus had boven de helft gezeten: 28 van 54 is 52 procent. Zo dicht bij elkaar liggen “bijna de helft” en “meer dan de helft”.
Tegelijk zegt dezelfde berekening iets wat de sceptici op X vergeten. De marge van het oude model loopt tot ruim 12 procent, die van Griffin begint bij 35. Die twee overlappen niet. De sprong van 1 naar 26 is geen toeval van een kleine groep.
Welk getal klopt: 48 procent van 54, of 45 procent van 120?
Vijf minuten na de aankondiging postte Aakash Gupta, die vooraf toegang had gekregen, andere cijfers. Volgens hem bekeken 120 mensen een videogesprek van 90 seconden en hield 45 procent de AI voor een mens.
Hij noemt er een opvallend detail bij. Een andere groep van 120 keek naar twee echte mensen, en 28 procent dacht dat één van hen de machine was. Dat zou de broodnodige vergelijking met mensen zijn. Op de onderzoekspagina van Tavus vonden wij die proef niet terug, en de 45 procent en de 28 procent ook niet.
Het zijn twee verschillende opzetten: kijkers die een gesprek beoordelen tegenover deelnemers die zelf bellen. Account The Daily Block voegde ze om 19.59 uur samen tot “45% in a 120-person study” bij “a 90-second conversation”. Zo ontstaat er binnen een uur een derde versie van hetzelfde nieuws.
Ook het vorige model schuift. De tweet zegt “<3%”, de tekst op de pagina “a max 2% pass rate” en de grafiek eronder 2,4 procent, 1 van de 41.
Wat heeft NVIDIA precies gemeten?
Tavus noemt Griffin “#1 on NVIDIA’s independent test of face-to-face AI”. Die test is VideoFDB, een benchmark van NVIDIA-onderzoekers met 237 fragmenten uit echte videogesprekken. Griffin-Lite staat bovenaan op de leaderboard.
Wie het onderzoeksartikel erbij pakt, ziet drie dingen. Griffin staat er niet in, die versie is van 28 juli. Wie wil meedoen, stuurt volgens de leaderboard zijn eigen uitvoer op en NVIDIA scoort die. En de beoordelaar is een taalmodel: gpt-4o leest transcripties en beschrijvingen van het beeld, gemaakt door andere modellen.
| Generatie-onderdeel | Score (0-5) | Reactietijd |
|---|---|---|
| Mensen (referentie) | 3,92 | 900 ms |
| Tavus Griffin-Lite | 3,83 | 1.892 ms |
| Gemini 2.5 + Anam | 2,80 | 2.840 ms |
| Gemini 2.5 + Keyframe | 2,39 | 3.520 ms |
Op dit onderdeel staan naast de mensen maar drie systemen. “Meer dan een punt voor” betekent hier: voor op twee koppelingen van Gemini met een avatar. En Griffin reageert nog altijd ruim twee keer zo traag als een mens.
Op het andere onderdeel, waarneming, staan acht modellen in vijftien regels. Zeven daarvan zijn dezelfde modellen nog een keer zonder beeld. Tavus spreekt van “the 15 models evaluated”. Griffin scoort daar 3,73, tegen 3,44 voor het open model MiniCPM-o 4.5 zonder beeld en 4,20 voor mensen.
De demo’s van Griffin zijn knip- en plakwerk
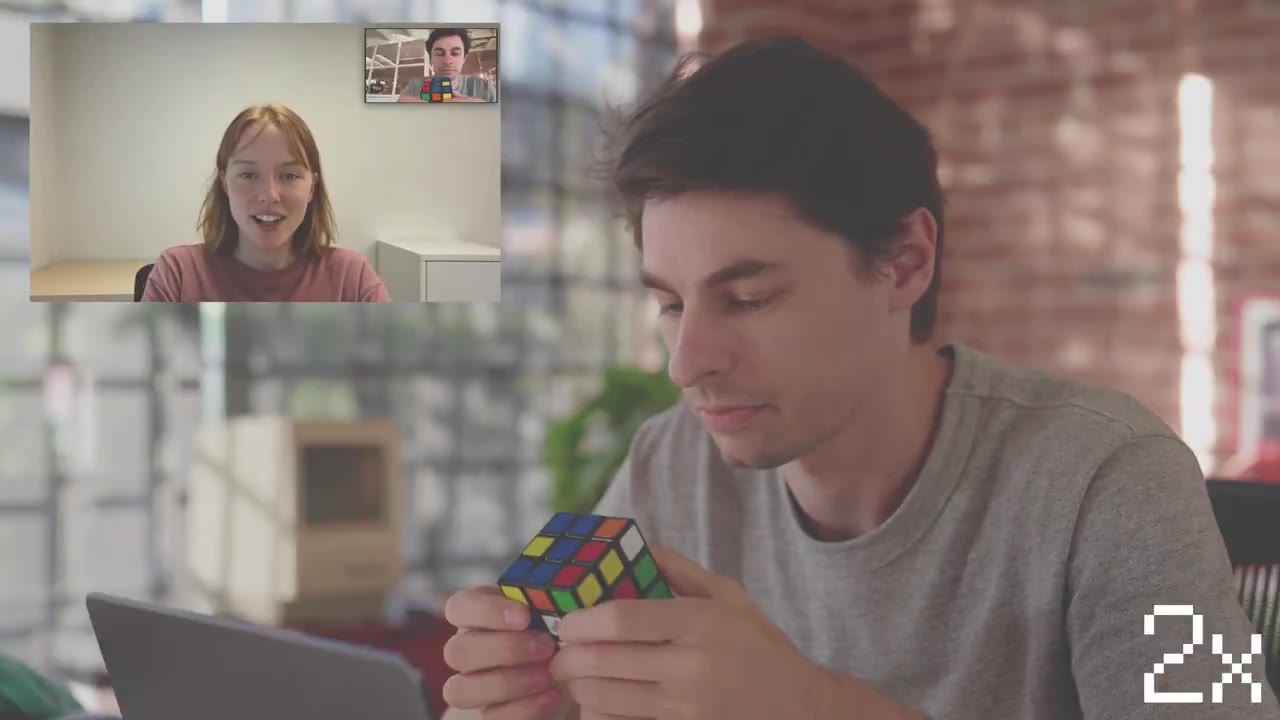
De video’s in de draad van Tavus zijn mooi. Een AI die meekijkt bij een Rubiks kubus, die meetelt bij het solderen, die “Simon zegt” speelt. Maar de kubusvideo loopt deels op dubbele snelheid, en in de soldeervideo wordt een stuk vooruitgespoeld. Dat is normaal voor reclame. Het is alleen geen live test.
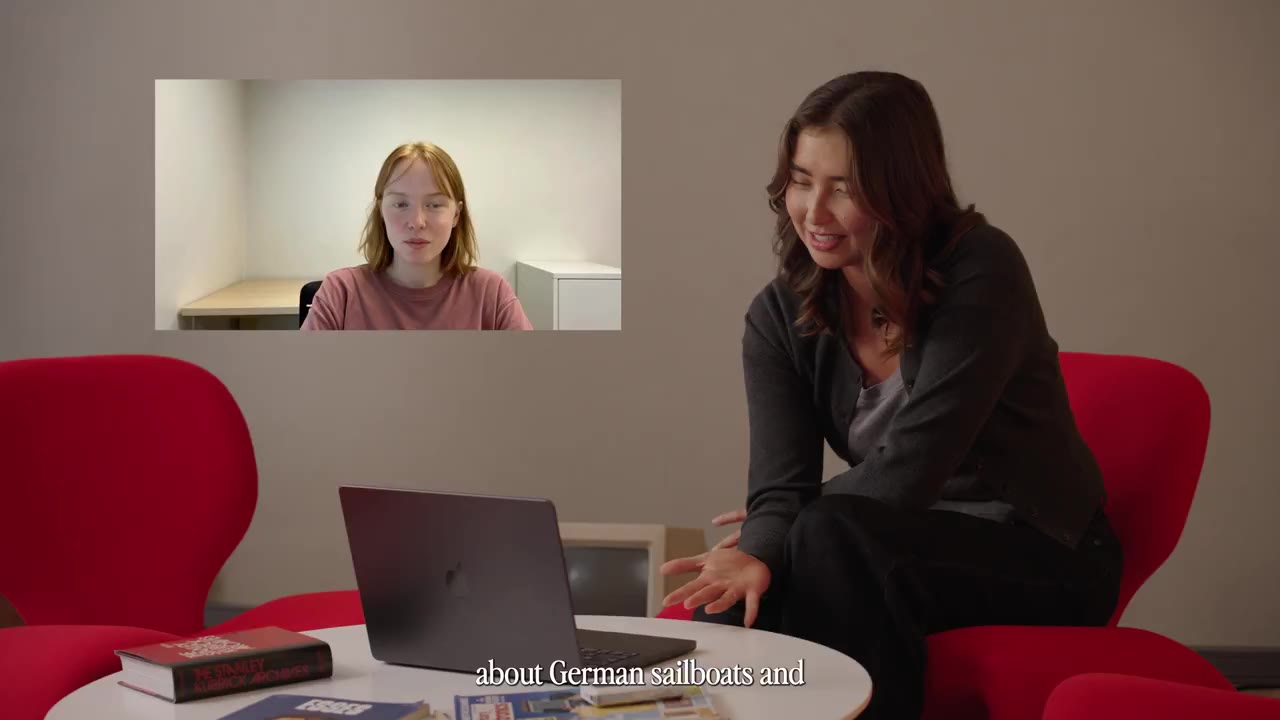
Wat wel opvalt in die beelden: Griffin wacht niet tot jij klaar bent. Het model beslist volgens Tavus elke fractie van een seconde of het iets zegt, knikt of zwijgt. Gewone spraakassistenten wachten op stilte en antwoorden dan. Die stilte verraadt ze.
Indrukwekkend, maar “geslaagd” is een woord van de marketingafdeling
Ons oordeel: de techniek is een echte stap. Van 2,4 naar 48 procent in dezelfde proefopzet is geen ruis. Wie dat afdoet als “kleine steekproef”, heeft de marges niet bekeken.
Maar een turing test haal je niet tegen mensen die niet weten dat er een test is. De mensen in deze proef keken niet kritisch, omdat niemand ze dat had gevraagd. Dat meet hoe overtuigend Griffin is voor een nietsvermoedende beller. Dat is iets anders dan niet van een mens te onderscheiden zijn, en voor de risico’s misschien zelfs belangrijker.
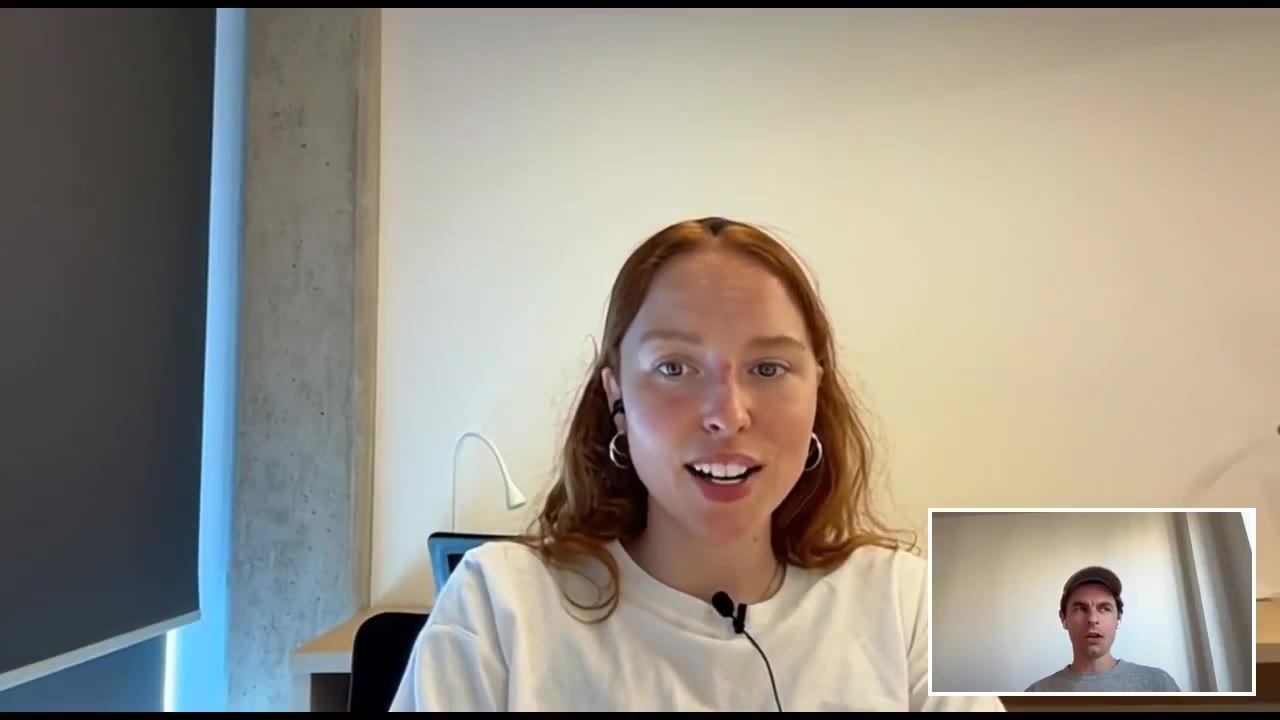
Topman Hassaan Raza schreef erbij: “The first time I saw it being used, I had no idea I was watching our model rather than just a normal video call.” Dat geloven we meteen. Hij wist alleen ook niet dat hij moest opletten.
Wie nu vooral de proefopzet afbrandt, en dat doen wij hierboven ook, mist wel iets. In het echte leven let ook bijna niemand op tijdens een videogesprek. Juist daarom is een nietsvermoedende beller de groep die ertoe doet.
Lees eerst de opzet voor je “geslaagd” gelooft
Zie je weer een kop dat een AI de turing test heeft gehaald? Stel dan twee vragen voor je het doorstuurt. Wisten de deelnemers dat ze een machine konden treffen? En was er een mens om mee te vergelijken? Twee keer nee betekent: overtuigend, niet geslaagd.
Wie wil snappen waarom dit nu ineens kan, begint bij generatieve AI en large language models. Op onze pagina wat is AI staat de basis, en de geschiedenis van AI laat zien hoe lang Turings vraag al meegaat.
Voor nep-video’s die al wel rondgaan, lees je hoe je een deepfake herkennen kunt. En over de risico’s van AI die zich als mens voordoet, gaat de AI Act ook: AI die rechtstreeks met mensen praat, moet laten weten dat het AI is.
Komt er een herhaling waarbij de bellers wel opletten?
Griffin-Lite is nu alleen beschikbaar voor een kleine groep testers. Tavus belooft “a wider release of a more powerful model” zodra het de veiligheid op orde heeft. Een tijdpad noemt het bedrijf niet.
De interessantste proef staat nog niet online: dezelfde minuut videobellen, maar met deelnemers die vooraf horen dat de helft van hun gesprekspartners een AI is. Blijft het percentage dan rond de helft hangen, dan is het woord “geslaagd” verdiend.