23 september 2026 · bijgewerkt 3 oktober 2026
Een bestand van 5,9 gigabyte, kleiner dan de meeste films, en wat erin zit mag zich vanavond meetellen op de wiskunde-olympiade. Iemand haalt het binnen, zet het naast een model van 54 gigabyte en laat allebei hetzelfde examenvak maken.
Eén van de twee past daarna gewoon op een flinke laptop.
Die vergelijking gebeurde echt, dinsdagavond 22 september om 23.26 UTC, dus in de nacht van dinsdag op woensdag om 01.26 Nederlandse tijd.
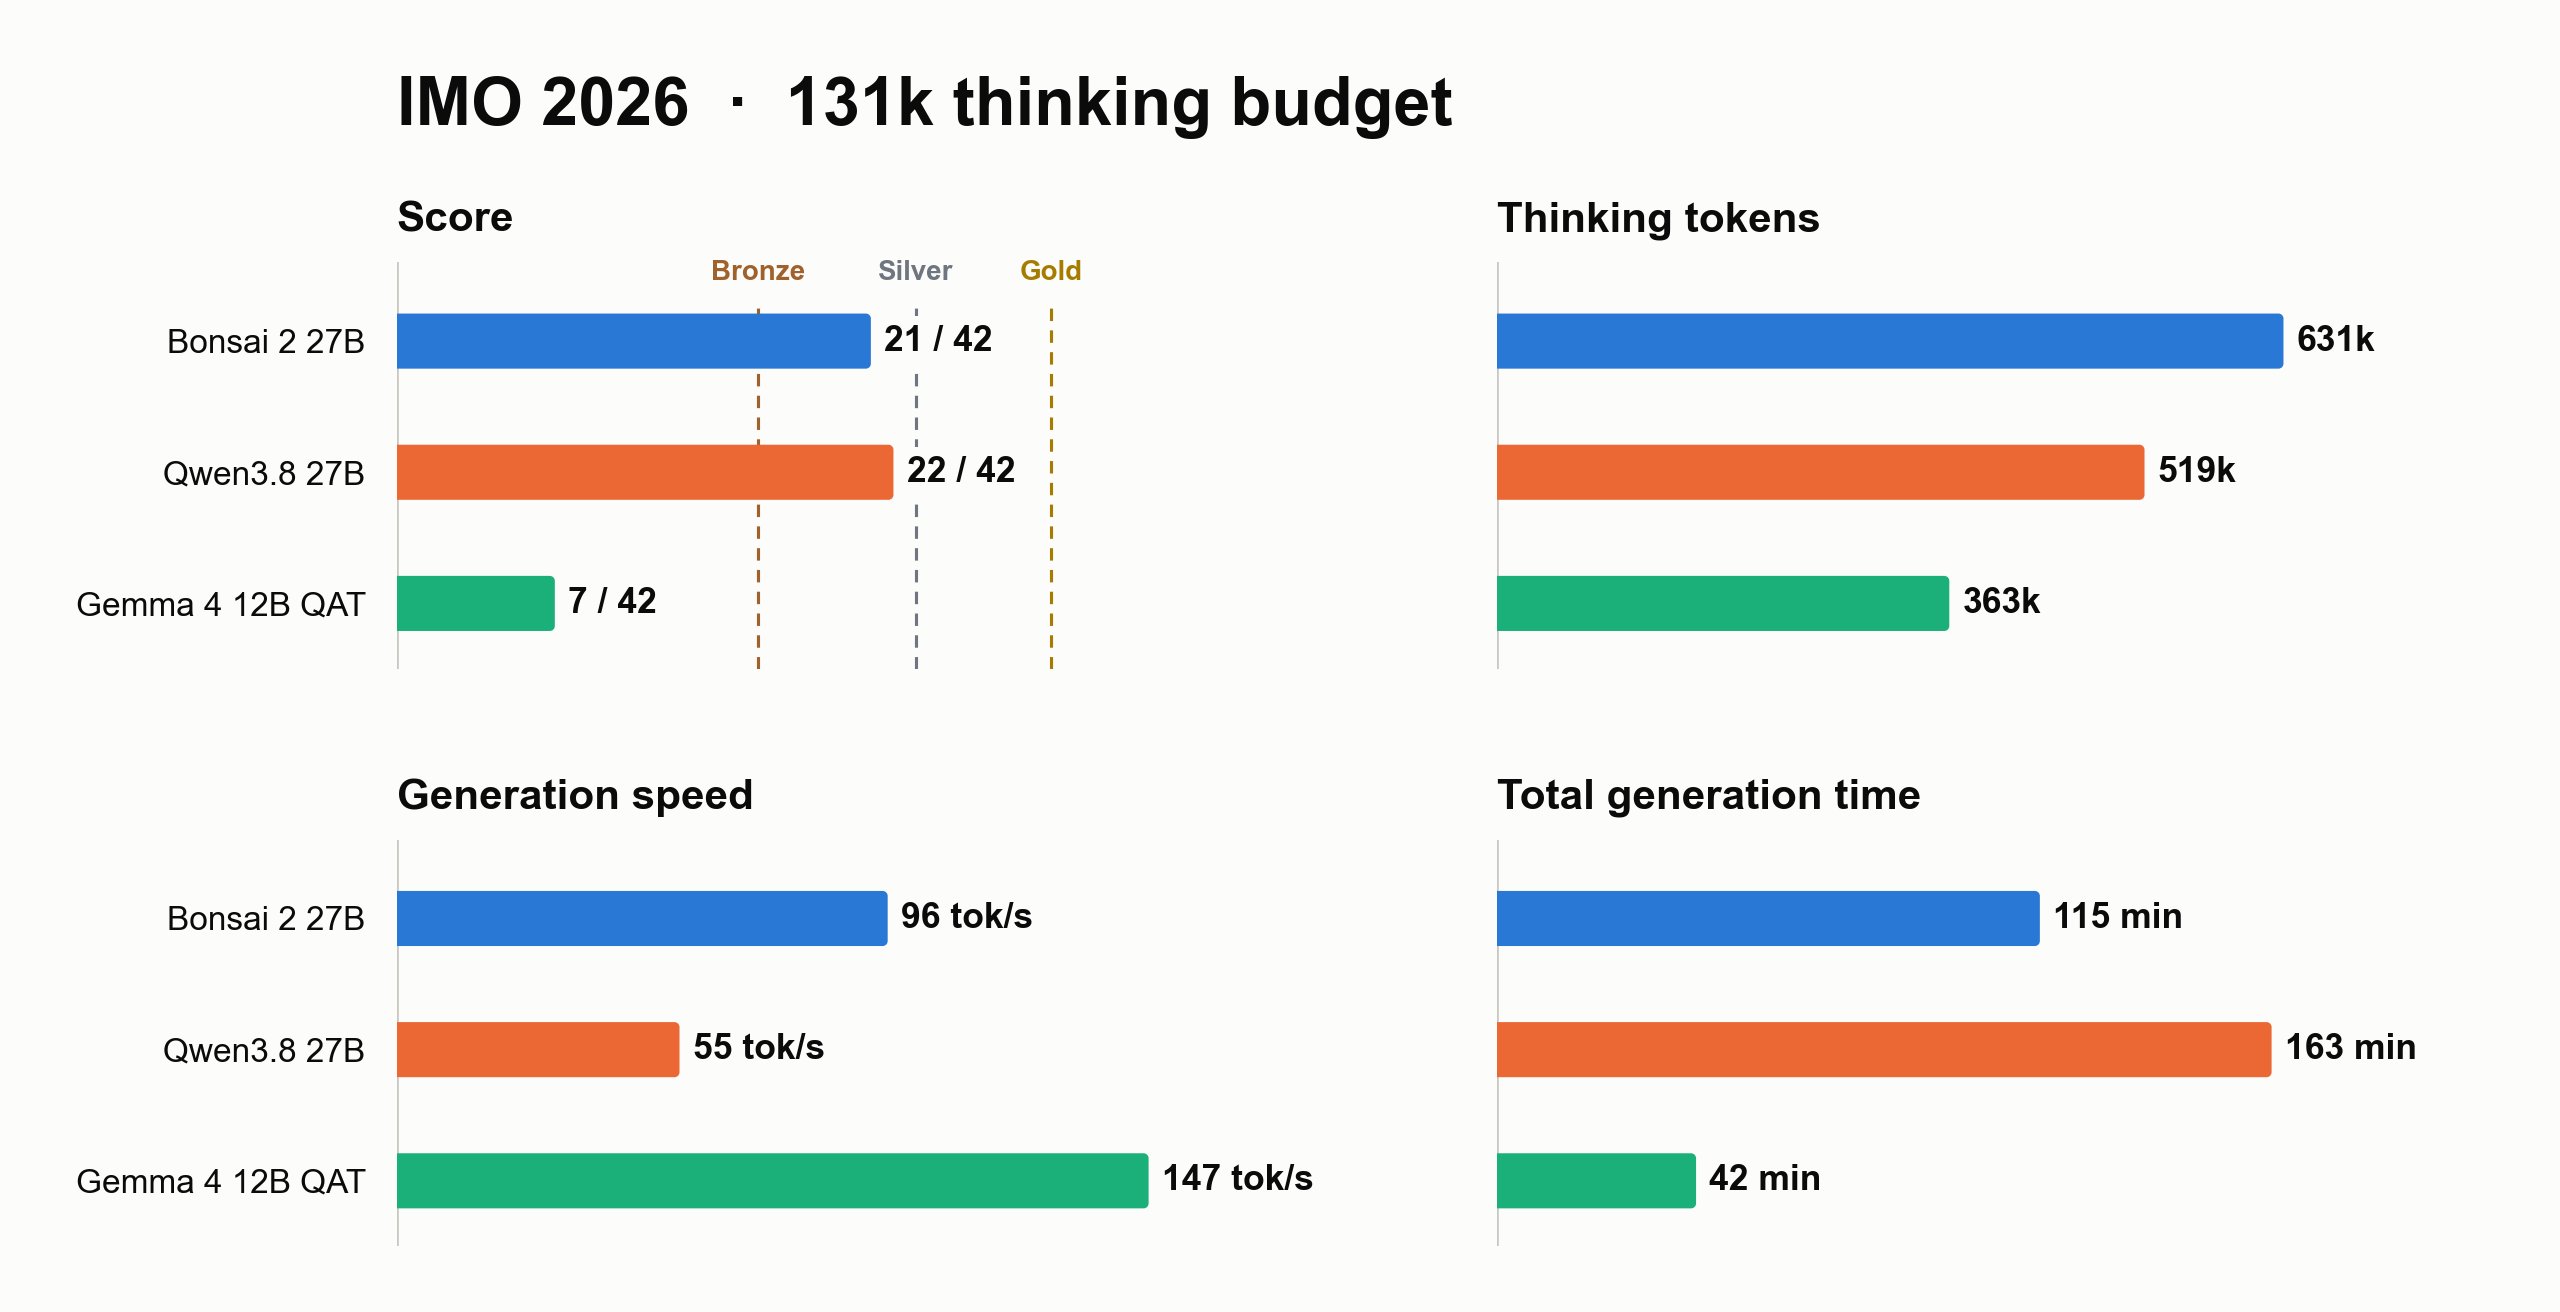
Barron, onderzoeker bij het Amerikaanse PrismML, postte de uitslag op X: zijn Ternary Bonsai 2 27B, 5,9 GB aan gewichten, haalde 21 van de 42 punten op IMO 2026, de wiskunde-olympiade van juli.
Het origineel waar hij van is afgeleid, Qwen3.8 27B op volledige precisie, haalde er 22. De test zelf staat in zijn draadje, met de aantekening dat de modellen geen internet, geen tools en alleen een kale omgeving kregen.
Binnen een dag stond de post op 21.784 weergaven, 124 likes en 92 bladwijzers, gemeten woensdagavond rond 20.55 uur. Die verhouding lees je bij dit soort posts meestal als: mensen bewaren hem om er zelf mee aan de slag te gaan.
Nou is een model niet zomaar “gecomprimeerd” tot 5,9 GB. Het verschil zit in hoe de rekenkundige bouwstenen, de gewichten, worden opgeslagen. Wie wil snappen waar we het over hebben, begint bij het begin: wat is AI eigenlijk, en wat bewaart zo’n systeem dan precies?
Een large language model bewaart die gewichten normaal als volledige decimalen, en daar zit Qwen3.8 27B op 54 gigabyte. De ternaire versie bewaart elke bouwsteen in plaats daarvan als één van drie waarden: min één, nul of plus één.
Per bouwsteen kost dat omgerekend zo’n 1,7 bit in plaats van 16, en de Hugging Face-modelcard rekent het precies uit: 27,36 miljard parameters, daarvan blijven er maar 26,2 miljoen, een tiende procent, op grotere precisie.
In dezelfde test stond als derde deelnemer Gemma 4 12B QAT, Googles zuinige 12-miljard-model: een half zo groot model uit een andere familie, en dat bleef op 7 van de 42 punten hangen. Wél was het het snelste van de drie.
Dat lage getal zegt vooral iets over modelgrootte: Gemma is een ander model, geen ingekrompen Qwen.
Het echte compressie-experiment staat daarom op de modelcard: een gebruikelijke 2-bits-variant van hetzelfde Qwen-model zakt op AIME26 naar 57,5 en op LiveCodeBench naar 56,4, terwijl de ternaire versie daar 95,8 en 90,1 blijft staan.
Op dit soort moeilijke toetsen is een slechte quant niet iets minder goed, hij is kapot.
De proefmaker is tegelijk de kandidaat
Wie heeft dit geteld? Barron werkt bij PrismML, het bedrijf achter het model.
De 98,2 procent behoud op de eigen benchmarksuite komt uit het eigen persbericht van 17 september, en ook MarkTechPost, dat het bericht oppikte, voegde daar expliciet aan toe dat het verhaal “not independently reproduced” is.
Ons oordeel: neem deze cijfers serieus, want de gewichten zijn open en Apache 2.0-gelicentieerd, en tegelijk met de post zette Barron een repo met volledige oplossingen en reproduceerbaarheid online. Maar het blijft een fabrikant die zijn eigen proefwerk nakijkt, tot iemand die niets met het model te maken heeft dezelfde tests herhaalt is dit een claim met bewijs erbij, geen onafhankelijk bewijs.
En één ding erbij: wij zijn zelf het soort site dat graag voor open modellen pleit, en dat maakt het 21-punten-verhaal aantrekkelijker dan het is.
Brons betekent brons: op dezelfde olympiade haalden de grote cloudmodellen van Anthropic, OpenAI en Moonshot alle 42 van de 42 in een onafhankelijke vergelijking met audit-trails. Wie vandaag het beste wiskundewerk wil, huurt een datacenter in.
Lokale modellen winnen op een andere vraag: wat past er in je eigen apparaat, en wat kost het.
Op Hacker News staat de lanceringsblog van 17 september inmiddels op 588 punten, en daar viert vooral de 16 GB-doelgroep de geheugenclaim van dit model.
De scherpte kwam van de andere kant: op een kaart van 32 GB past een goede 6-bits-versie van het origineel ook, en die is nog beter. Beide dingen kloppen tegelijk, en van de twee is de geheugenwinst de echt nieuwe.
Past het op jouw machine?
Op de modelcard staat een tabel met per kaart hoe snel het model wegloopt: een RTX 5090 haalt volgens die meting 129,9 tokens per seconde, een RTX 4090 tussen de 81 en 91, en een laptop-M5 Pro circa 28 met een verbruik van 27,5 watt.
Check of jouw kaart in die tabel staat, dat kost een minuut.
Wie geen eigen model wil draaien maar gewoon wil chatten, vindt in onze uitleg wat ChatGPT is en hoe je het gebruikt de makkelijkere route, en wie zich afvraagt of zo’n klein model wel veilig genoeg is, leest bij de risico’s van AI waar je dan op let.
Eén kanttekening bij die tabel: hij is van PrismML zelf, en de man die de olympiade-test draaide werkt er ook. Het moet dus nog bewezen worden door iemand die niets met het model te maken heeft.
Het mooie is dat dit keer alles ervoor klaarligt: de gewichten zijn open, de licentie staat erbij, en de downloads lopen inmiddels in de miljoenen.
Dat modellen eerst in de API landen en pas later bereikbaar worden voor gewone gebruikers, zagen we gisteren ook: Sol en Luna van OpenAI zitten nog niet in de chat.
Wie herhaalt dit proefwerk?
Het moment dat hierna telt is de eerste keer dat een onafhankelijke partij dezelfde test herhaalt. Bevestigt die het vergelijk, dan is 5,9 GB voor deze klasse het nieuwe normaal; valt die tegen, dan was 21 op 42 te mooi om waar te zijn. Tot die tijd staat de score erbij met open gewichten en een repo vol oplossingen, en mag iedereen het proefwerk nakijken.
Zolang die herhaling er niet is, blijft 21 op 42 het eerlijkste getal van dit verhaal: bijna even slim als het origineel, in nog geen negende van de ruimte, en nog altijd geen goud.